
Nie tak dawno robiłem testy badając możliwość obsługi kamery cyfrowej przez mikrokontrolery Cortex M7. Jeden badanych zestawów posługujący się pamięcią dynamiczna miał wyraźnie słabsze osiągi, nieporównywalnie mniejsze niż wynikało by to z niższej częstotliwości taktowania. Wyciągnąłem wtedy wniosek że pracuje wolniej dlatego, że jest wyposażony w pamięć dynamiczną wymagającą odświeżania i mającą bardziej skomplikowane adresowanie, osobno rzędy i kolumny. W swoim projekcie potrzebuję obrabiać obraz z kamery, więc zastosowałem najszybsza jaka znalazłem w tym rozmiarze pamięć statyczną IS61WV204816BLL-10TI, ale też dorzuciłem pamięć dynamiczną AS4C32M16SC-7TIN, tak na wszelki wypadek gdyby okazało się że będę potrzebował więcej pamięci niż założyłem na początku. Oba układy pracują na wspólnej 16-bitowej magistrali danych.
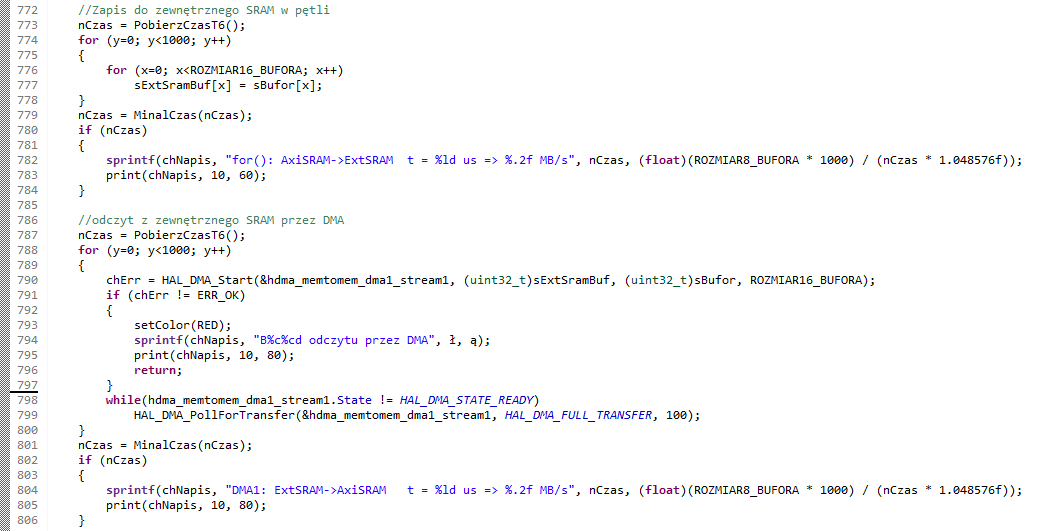
Obecnie dotarłem do etapu, gdzie mam już uruchomioną obsługę wszystkich pamięci i mogę je porównać. Jako próbkę testową stosuję 1000-krotne przesłanie bufora 256 słów 16-bitowych między badaną pamięcią a najszybszą dostępną w kontrolerze, czyli Axi-RAM. W Przypadku użycia DMA po rozpoczęciu transferu czekam na jego zakończenie. Przed rozpoczęciem pomiaru pobieram czas z 16-bitowego timera liczącego z rozdzielczością 1us, rozszerzonego 16-bitowym timerem programowym inkrementowanym w przerwaniu timera. Po zakończeniu transferu ponownie pobieram czas i liczę różnicę. Procedura pomiarowa dla przypadku pętli for() oraz DMA wygląda następująco:
Wyniki rysuję na ekranie a cały test wygląda tak jak na poniższym obrazku. Pomiary badanej pamięci wykonywane są parami dla zapisu i odczytu.
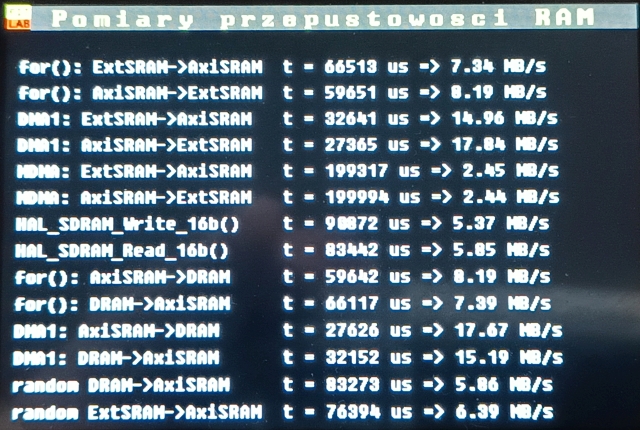
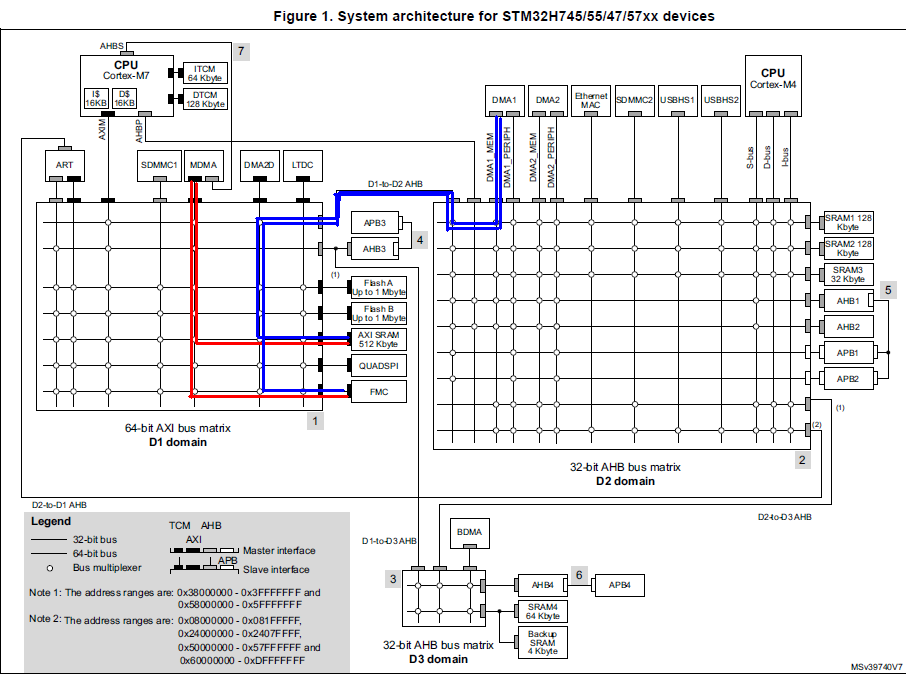
Pierwsza para to transfer z i do zewnętrznej pamięci SRAM robiona w pętli for(). Kolejna para tan sam transfer robiony przez DMA1, jeszcze kolejna para wykorzystuje MDMA. O ile wykorzystanie DMA praktycznie podwoiło transfer to z pracą MDMA jest wyraźny problem. Być może czegoś jeszcze nie potrafię skonfigurować. Jeżeli patrzymy na architekturę pamięci kontrolera to transfer przez MDMA ma krótszą drogę niż przez DMA1. Dzieje się w obrębie jednej domeny, nie trzeba pokonywać mostu D1-to-D2 AHB, więc powinien być dużo szybszy.
Kolejne zaskoczenie to dedykowane funkcje HAL do odczytu i zapisu z pamięci dynamicznej osiągają transfery gorsze niż pętla for() o 50% dla zapisu i 26% dla odczytu. Największym zaskoczeniem jest jednak bardzo mała różnica w transferze danych między pamięcią dynamiczną i statyczną. W przypadku pętli for(), prędkość jest praktycznie taka sama, w przypadku transferu po DMA pamięć dynamiczna jest wolniejsza o 1% w przypadku zapisu i 1,5% w przypadku odczytu. Jeżeli tutaj nie ma jakiegoś haczyka, to nie ma sensu używanie znacznie droższej pamięci statycznej, która wymaga większej magistrali adresowej (SRAM 21 bitów, DRAM 15 bitów).
Próbując znaleźć haczyk pomyślałem że różnica pewnie będzie widoczna, gdy dostęp zmieni się z liniowego na sekwencyjny, więc aby wykluczyć wpływ cache i braku konieczności pełnego adresowania dla kolejnych komórek DRAM zrobiłem test losowego dostępu. Ponieważ losowanie adresu nawet przy wsparciu sprzętowym zajmuje chwilę i wyraźnie wpływa na wynik, więc przygotowałem tablicę 256 adresów, napełniam ją losowymi adresami przed testem, a potem w pętli pomiarowej czytam lub piszę pod te adresy. Wynik z definicji musi być trochę gorszy, bo dochodzi jedna operacja odczytu adresu, ale robiąc to samo na zewnętrznych pamięciach SRAM i DRAM, nie widzę wyraźnego spadku wydajności w porównaniu do transferu ciągłego. Test random (ostatnie 2 pomiary na ekranie) należy porównywać do odczytu w pętli for(). Różnica między pamięcią statyczną i dynamiczną wyszła na poziomie 9% a spadek transferu losowego w porównaniu do liniowego odczytu w pętli wynosi odpowiednio 26% wolniej dla DRAM i 15% dla SRAM.
Flash
Mając już opracowane narzędzia wykonałem pomiary zewnętrznej pamięci flash NOR S29GL256S90TFI023 pracującej na 16-bitowej magistrali równoległej. Porównywany jest transfer odczytu przy użyciu dedykowanej funkcji HAL, odczytu w pętli for(), odczytu przez DMA1 i MDMA. Żeby mieć punkt odniesienia, dodałem porównanie z odczytem pamięci flash kontrolera i najszybszym możliwym odczytem Axi-RAM. Tutaj przesyłam ten sam bufor mieszczący 256 słów 16-bitowych, ale przesyłam go 16 razy a nie 1000 jak wcześniej, już nie pamiętam dlaczego.
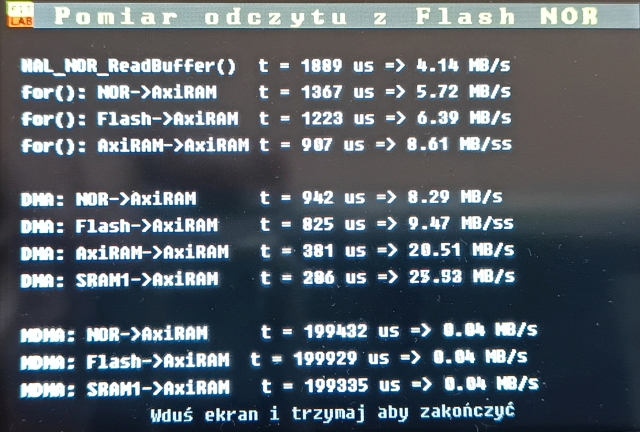
Tutaj jest wyraźnie większy transfer w przypadku użycia DMA i zupełna kicha przy stosowaniu MDMA bez względu na rodzaj pamięci.
Flash Quad SPI
W urządzeniu mam jeszcze jedną pamięć W25Q128JVSI na magistrali QSPI. Chciałem zobaczyć jaka będzie różnica między użytkowaniem pamięci z dostępem równoległym a szeregowym. Napisałem obsługę i uruchomiłem, ale na obecną chwilę niewiele więcej, bo układ mnie rozczarował. Pamięć ma możliwość przesyłania danych i adresów po klasycznym, 1-przewodowym SPI, oraz po 2 i 4 przewodowym. Napisałem dwa testy odczytu. Jeden przesyła dane po 1-bitowej magistrali adresowej i 1-bitowej magistrali danych (W25_CzytajDane1A1D), drugi test pracuje na obu magistralach 4-bitowych (W25_CzytajDane4A4D). Finalny transfer uzyskałem praktycznie taki sam. Wynika z tego że wąskim gardłem tej pamięci nie jest magistrala. W czasie pisania tego artykułu zauważyłem że linie QSPI są skonfigurowane na najniższą prędkość (LOW) i dla tego ustawienia udało mi się dojechać z zegarem do 63MHz. Teraz przestawiłem na HIGH i udało się uzyskać pracę na 81,2MHz oraz na 102,4MHz, jednak nie zmieniło to wyników testu, tak więc prędkość taktowania też nie jest wąskim gardłem tego układu.
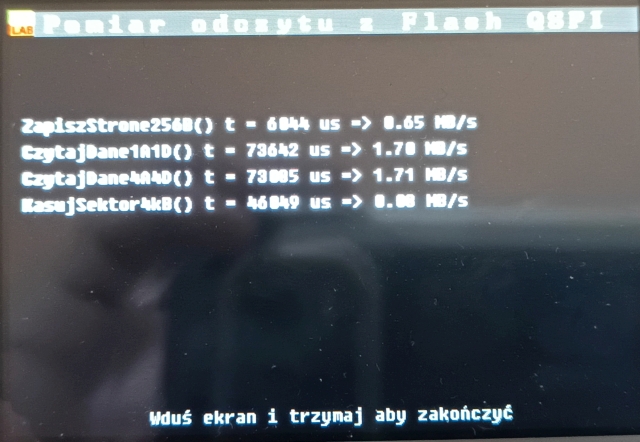
Wydaje mi się że uzyskałem informację, którą chciałem uzyskać wstawiając tą pamięć do projektu. Pamięć QSPI może być atrakcyjna w projekcie, w którym miniaturyzacja ma wyższy priorytet niż prędkość. W projekcie gdzie musi być zewnętrzna magistrala, albo wymagany jest większy transfer niż 1,7MB/s, stosowanie jej nie ma sensu. Pozbędę się jej w następnej wersji sprzętu.
Skąd biorą się różnice prędkości transferu?
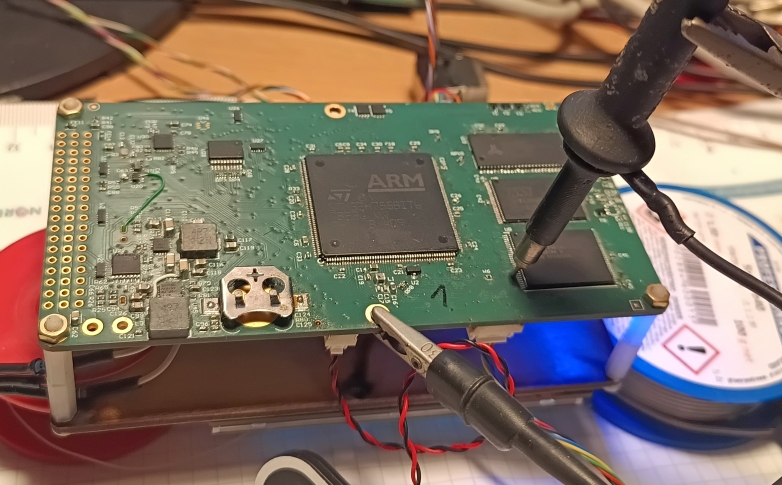
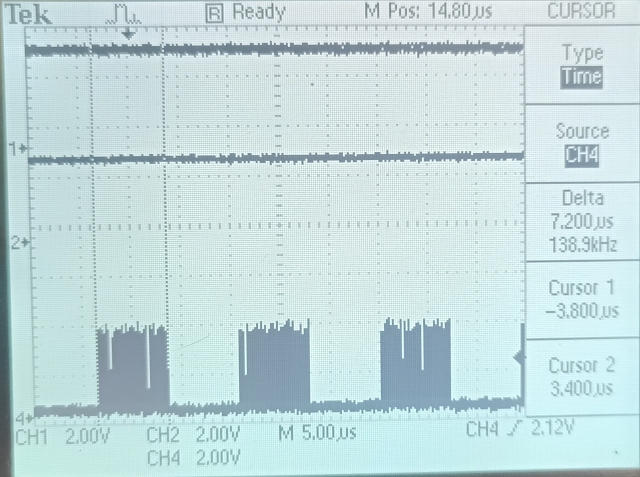
Różnice pomiędzy dostępem z poziomu pętli for() a dostępem z poziomu DMA wynikają z tego, że DMA ma ciągły dostęp do pamięci i w pełni wykorzystuje jej przepustowość, natomiast pętla for() robi przerwy na wykonanie programu realizującego pętlę. Na poniższych oscylogramach widać stan z linii adresowej A5. W Przypadku pętli for() przesłanie 256 słów zewnętrznej pamięci SRAM zajmuje 7,2us, potem jest mniej więcej drugie tyle przerwy na obsługę pętli.
Natomiast w przypadku DMA transfer tej samej paczki danych zajmuje 2,8us a krótsza przerwa między paczkami prawdopodobnie wynika z obsługi tylko jednej pętli.
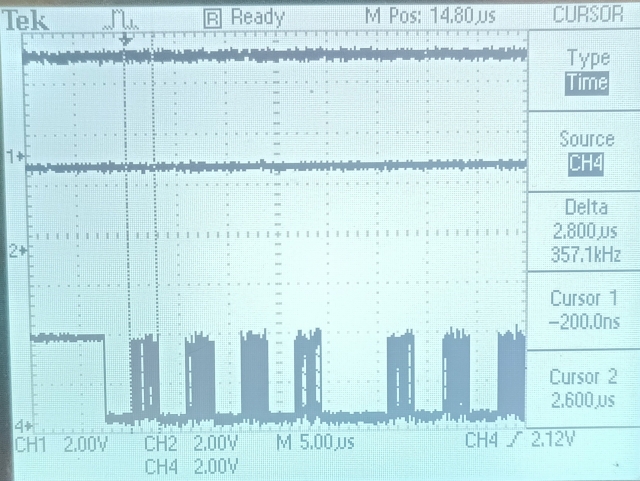
Po oscylogramach widać że ten mój test jest trochę oszukany, bo chyba nierozsądne jest powtarzanie go w pętli. Gdybyśmy mierzyli sam transfer wyniki było by około dwukrotnie większe. Jednak w rzeczywistym zastosowaniu pętle są czymś nieuniknionym i taki test lepiej oddaje rzeczywistość.
Przy okazji zbierania oscylogramów okazało się dlaczego transfer przez MDMA jest tak wolny i równy dla wszystkich rodzajów pamięci. Po prostu na magistrali nic się nie dzieje.
Gdyby ktoś potrzebował więcej informacji o programie, to jego repozytorium jest na Githubie. Pomiary wydajności są robione w kodzie rdzenia CM7 w plikach flash_nor.c (pomiary dla NOR i SRAM) oraz W25Q128JV.c (pomiary dla QSPI).