
 Uważam, że podczas rozwoju jakiegokolwiek projektu, występowanie błędów jest czymś normalnym. Jest wartością zasilającą sprzężenie zwrotne w pętli doskonalenia produktu. Im efektywniejszy będzie proces ich znajdowania, tym szybciej projekt osiągnie dojrzałość. Już w trakcie implementacji obsługi błędów znalazłem kilka problemów, z których wcześniej nie zdawałem sobie sprawy. Debugowanie wymusza ponowny przegląd kodu mającego nierzadko kilka lat. Spojrzenie na niego jeszcze raz z nowej perspektywy pozwala zauważyć nowe rzeczy. Można to porównać do gry, w której trzeba znaleźć drogę w labiryncie pełnym pułapek. W pierwszej kolejności trzeba zbudować sobie w głowie mapę zauważonych pułapek. Nigdy nie wiadomo, czy wszystkie już zostały znalezione. Powstający kod jest opisem przejścia przez ten labirynt. W kodzie opis pułapek jest zwykle pomijany, czasami jest coś wspomniane w komentarzu, ale w ogólności przy powtórnej wizycie w tym miejscu trzeba zbudować mapę jeszcze raz. Ponieważ ścieżka jest już wyznaczona, spojrzenie na labirynt jest zupełnie inne, niż wtedy gdy patrzyliśmy na niego za pierwszym razem. Nierzadko można znaleźć lepszą drogę. Dlatego warto wracać do kodu, a już na pewno wtedy, gdy stwarza on zauważalne problemy.
W złożonym systemie, jakim jest APL3, mającym wiele trybów pracy i obsługującym wiele poleceń, jest prawdopodobne, że mogą nastąpić okoliczności, w których pewne mechanizmy nie będą działały tak, jak powinny. Przyczyną może być nieoczekiwana konfiguracja, błąd czujnika czy nieprzystosowanie kodu do zmienionych warunków pracy. Wystąpienie takich sytuacji jest ewidentnym błędem i warto byłoby mieć świadomość, że taka sytuacja ma miejsce. Można wtedy zareagować, poprawiając oprogramowanie lub zmieniając warunki pracy. W przypadku rdzenia CM7, mającego swój interfejs użytkownika, informację o błędzie można wyświetlić jako komunikat na ekranie, ale jak poinformować o sytuacji z błędem w rdzeniu CM4?
Do niedawna stosowałem mechanizm wypracowany w APL2, gdzie wystąpienie sytuacji z błędem sygnalizowane było świeceniem diody RGB statusu na czerwono. Teraz też tak jest, ale to za mało. Wciąż nie wiadomo, co to za błąd i jak go obsłużyć. Wcześniej strumień błędów rejestrowany był w logu. To jest jakieś rozwiązanie, podobnie mógłby być przesłany w telemetrii, ale CM4 nie ma dostępu do rejestratora ani do telemetrii. Ponadto pracuje z dosyć dużą prędkością i może sypnąć strumieniem rzędu kilku tysięcy błędów na sekundę. Jak w takiej sytuacji nie przegapić czegoś ważnego?
Przesyłanie ostatnio uchwyconego błędu nie sprawdziło się, ponieważ pełen obieg pętli obsługuje kilkadziesiąt poleceń. Miało-by to sens na krótszym etapie, gdzie zwracany jest tylko jeden wynik. Każdy następny błąd powoduje przykrycie wcześniejszych. Rozwiązaniem zdającym egzamin okazało się zastosowanie bufora kołowego dołączonego do pętli wymiany danych między rdzeniami. Nie musi mieć dużego rozmiaru, obecnie sprawdza się 8-elementowy. W przypadku wystąpienia ciągłego błędu zapełnia się on w ułamku sekundy, ale zawiera sekwencję kolejnych błędów z tego okresu, co pozwala na obserwację tego, czy jest to jeden jednorazowy błąd czy ciągły strumień. Znajomość ostatnich 8 kodów błędów i ich dystrybucja w czasie jest w praktyce wystarczająca. Takim szczególnym przypadkiem jest inicjalizacja sprzętu robiona jednorazowo po starcie. Przegapiony błąd już się nie powtórzy, ale może mieć wpływ na dalszą pracę. Inną wagę ma błąd braku czujnika, który może, ale nie musi być zawsze podpięty, inną błąd inicjalizacji czujnika krytycznie ważnego.
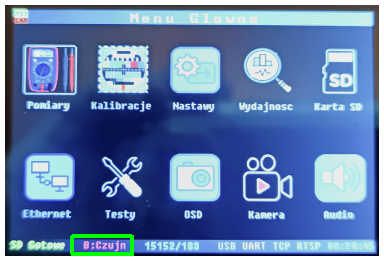 W pasku statusu ekranu wyświetlającego menu wygospodarowałem pole o szerokości 8 znaków, gdzie wraz ze zmianą sekundy na zegarze wyświetla się skrócony opis kolejnego błędu z bufora. Jest to pole zaznaczone zieloną ramką na obrazku obok. Pokazuje błąd inicjalizacji czujnika, Błędy są pokazywane w kolorze czerwonym, ich brak w kolorze zielonym, tak aby pojawienie się problemu przyciągało wzrok. Błąd prawie nigdy nie będzie jednoznaczny. Trzeba uruchomić sesję debuggera, jednak zawarte w buforze kody błędów zwykle wystarczą, aby wiedzieć, gdzie rozpocząć poszukiwania i czego szukać.
W przypadku jednorazowego błędu, np. niepowodzenia inicjalizacji opcjonalnego czujnika, który może być podłączony do magistrali I2C, ale w tej chwili nie jest, zastosowano mechanizm okresowego kasowania błędów starszych niż kilkadziesiąt sekund, aby nie epatować użytkownika pojedynczym błędem przez cały czas pracy. Tak więc jeżeli mignie czerwona dioda, warto spojrzeć na pasek statusu, bo informacja może zniknąć po kilku cyklach wyświetlania. Te cykle nie są najlepszym pomysłem, bo mogą sugerować że jednorazowy błąd pojawia się kilkukrotnie, ale na razie nie mam lepszego rozwiązania.
Jeszcze innym aspektem jest pisanie takiego kodu, który dostrzeże problem i zwróci błąd. Początkujący programista zwykle nie zwraca na to większej uwagi. Pisząc warunek if(), skupia się na tym, co ma być osiągnięte w danym warunku. Doświadczony programista wie, że warto zastanowić się również nad częścią else, gdzie warunek nie jest spełniony, bo tam może być ukryty potencjalny problem. Definiując switch(), zawsze oprócz listy case warto dodać etykietę default i ustawić tam kod błędu, bo chociaż dzisiaj mamy obstawione wszystkie warunki, to być może za jakiś czas użyjemy funkcji do czegoś innego i pojawią się nieobsłużone sytuacje, które bez tego nie zostałyby zauważone. Warto robić wstępną walidację danych, bo śmieci na wejściu powodują, że na wyjściu też będą śmieci, dlatego warto zauważyć je już na początku drogi.
Funkcje często są głęboko zagnieżdżone. Co z tego, że funkcja na samym spodzie zwróci błąd, jeżeli nie zostanie on przekazany na górę. Trzeba wyrobić sobie nawyk, aby oprócz wyniku funkcji odbierać i przekazywać dalej kod błędu. W kodzie APL3 większość funkcji zamiast wyniku zwraca właśnie kod błędu, a ewentualny wynik jest przekazywany przez wskaźnik. Początkujący programista ma tendencję do pisania kodu jako wielkiej funkcji wykonującej jednocześnie wiele zadań, bo tak jest mniej pisania, mniej interfejsów wejścia i wyjścia danych. Raz, że taką funkcję trudniej jest zrozumieć i modyfikować, to jeszcze trudno wyprowadzić z niej informację o błędzie. Znacznie lepiej sprawdza się zestaw krótszych funkcji robiących jedną rzecz.
Jeszcze jedną rzeczą jaką próbuję stosować jest stosowanie assertów. To nie zwraca wyników i w dodatku podstępnie zatrzymuje program, przynajmniej ten w wersji debug, jednak jest pułapką na wystąpienie anomalii danych. Przykładowo podczas inicjalizacji uruchamiany jest kontroler PID na testowych danych, a zwracany przez niego wynik jest porównywany ze stałymi, definiującymi wąski przedział niezależnie wyliczony dla bieżącej konfiguracji. Już raz zdarzyła się sytuacja, że program zatrzymał się na assercie, bo modyfikując pewną rzecz, w sposób nieintencjonalny zmodyfikowałem działanie PID-a. Normalnie nie zostało by to zauważone, jednak assert zatrzymał program i wymusił sprawdzenie poprawności kodu, pomimo że miałem do zrobienia coś innego.