
W ramach pracy nad nowym projektem autopilota postanowiłem sprawdzić możliwość wykorzystania obrazu do usprawnienia nawigacji. Dostępność systemów satelitarnych sprawiła, że trudne zadanie nawigacji w terenie zostało zautomatyzowane. Jednak żyjemy w czasach, w których nie możemy być pewni ciągłej dostępności tych usług, dlatego potrzebna jest alternatywa, aby w godzinie próby nie obudzić się z ręką w symbolicznym nocnym naczyniu.
Istnieje powszechna świadomość wykorzystania obrazu przez człowieka do rozpoznania znanego terenu. W Wikipedii jest takie hasło jak torodroma, które w żartobliwy sposób definiuje metodę wytyczania trasy przelotu samolotu w pionierskich czasach, kiedy nie było jeszcze GNSS. W trakcie wojny na Ukrainie słyszałem o metodzie określania pozycji na podstawie dopasowania obrazu do mapy terenowej. Szachownica pół uprawnych, dróg i lasów jest często na tyle charakterystyczna, że sieć neuronowa jest w stanie skorelować obraz kamery z obrazem na mapie terenowej.
Od dosyć dawna istnieje też metoda „optical flow”, którą na co dzień posługujemy się w optycznych myszach komputerowych. Metoda określa kierunek i wielkość przesunięcia między kolejnymi obrazami zarejestrowanych przez mysz lub bezzałogowca i wyznacza z nich wektory przesunięcia. Użycie metod zliczeniowych do sumowania wektorów z kolejnych obrazów pozwala na określenie bieżącej pozycji. Metoda daje przyrosty względne, więc sumowanie w skali bezwzględnej musi generować pewien błąd, który z czasem będzie narastał, jednak prędkość jego przyrostu wydaje się, że powinna być w miarę stała. Porównując to z danymi GNSS i INS, można próbować wykryć sytuację pojawienia się zakłóceń GNSS. W szczególności spoofing sygnału, który, jak mi się wydaje, jest jedną z metod walki radioelektronicznej z dronami. Chyba każdy widział obrazki z wielkimi, elektronicznymi „strzelbami” do walki z dronami. Są w stanie sprowadzić drona na ziemię. To znaczy, że co najmniej niektóre z nich muszą robić spoofing, czyli fałszowanie wskazań np. wysokości. Tak sądzę, ponieważ przed samym zagłuszeniem sygnału, np. przez emisję nośnej modulowanej szumem o częstotliwości transmisji danych GNSS można się obronić, odpowiednio definiując warunki reakcji na fail safe.
Jest to ciekawy temat i mając sporo wolnego czasu, warto się nim zająć. Połączenie metody „optical flow” z rozpoznawaniem charakterystycznych punktów może pozwolić na kasowanie błędów zliczeniowych i nawigację przynajmniej po terenie, który posiada w miarę stałe szczegóły morfologiczne (nie może to być morze). Być może w trakcie zmagania się z oporem materii wpadnie do głowy jakiś nowy pomysł.
Poniżej opisuję pierwszy etap tej przygody, czyli proces tworzenia narzędzi do uzyskania obrazu, jego rejestracji „in situ” i kompresji przed wysyłką.
Koncepcja sprzętu
Wybierając sprzęt, na którym mogę zrobić autopilota z możliwościami obrazowania, czyli przede wszystkim mikrokontroler, zdefiniowałem kilka kryteriów:
- Musi mieć przynajmniej elementarne możliwości pozyskania i obróbki obrazu, niekoniecznie w dużej rozdzielczości. Chodzi o rozpoznanie metody, a nie o zrobienie najlepszego urządzenia na świecie.
- Musi być to możliwe do wykonania dostępnymi narzędziami. Dlatego, o ile to możliwe, unikam układów w obudowach BGA.
- Oprogramowanie systemowe musi być do udźwignięcia dla prostego programisty mikrokontrolerów, który do tej pory pracował głównie w środowisku CMSIS. Zdecydowałem się na HAL i RTOS, czyli to, co każdy współczesny programista embedded powinien umieć. Systemy oparte na Linuksie, na tym etapie przekraczają moje możliwości intelektualne. Jednak wszystkie znaki wskazują, że wkrótce trzeba będzie się z nimi zmierzyć.
- Musi być bogate w peryferia na tyle, aby obsłużyło wszystkie interfejsy potrzebne autopilotowi w locie. Dlatego odpadają ciasne rozwiązania jak Raspberry Pi, które posiadają interfejs do obsługi zaledwie ułamka funkcjonalności, którą chciałbym mieć w urządzeniu.
- Musi dać się to wyprodukować, być elastyczne i skalowalne, dlatego poza rozpoznaniem tematu odpadają gotowe zestawy uruchomieniowe. W ogólności nie jest to istotny warunek, raczej przyzwyczajenie człowieka, który przez większość dorosłego życia musiał coś produkować, aby przeżyć. Mimo wszystko chciałbym, aby w wyniku tej przygody powstało coś fizycznie używalnego, nie tylko idea.
- Skoro będzie musiało być wyprodukowane co najmniej w kilku prototypowych egzemplarzach, musi kosztować tyle, aby udźwignął to budżet hobbysty.
Zdecydowałem się na dwurdzeniowy mikrokontroler STM32H755 w obudowie LQFP208. Rdzeń Cortex 4 pracujący na 240 MHz obsługuje funkcjonalność autopilota, a Cortex 7 pracujący na 480 MHz powinien dać radę obsłużyć komunikację ze światem i obróbkę obrazu. Istnieją wydajniejsze procesory, dedykowane do obróbki obrazu np. seria STM32MP2, ale nie wiem, czy obecnie dałbym radę udźwignąć system, w którym magistrale taktowane są 1,5 GHz. Posiadanym oscyloskopem nawet nie zobaczę, co się na nich dzieje. Poza tym przy obudowach BGA może nie być miejsca na przyłożenie sondy. Z wybranym H7 jestem przekonany, że sobie poradzę, pomimo że jest to pierwszy tak szybki kontroler w moich rękach.
Kamera
Przez określenie kamera rozumiem układ przetwornika obrazu, co najwyżej moduł z przetwornikiem, a nie gotowe, komercyjne urządzenie. Na rynku są dostępne kamery cyfrowe z interfejsem DCMI (ang. Digital Camera Interface) oraz nowszym, wprowadzonym w latach dwudziestych XXI wieku interfejsem CSI (ang. Camera Serial Interface). Interfejs DCMI jest równoległy, zwykle 8-12 bitowy. Posiada linię dla zegara taktującego, synchronizację poziomą określającą kolejny wiersz i pionową określającą kolejną klatkę obrazu. Interfejs CSI jest szeregowy i posiada 1 lub 2 strumienie pracujące z wysoką częstotliwością. Mogłoby się wydawać, że interfejs równoległy powinien mieć większą przepustowość, jednak to interfejsy strumieniowe pozwalają na obsługę kamer z większą rozdzielczością i częstotliwością pozyskiwania klatek obrazu. DCMI pracuje z zegarem do 30 MHz (typowo 24 MHz), natomiast CSI pracuje z zegarem od 1,25 do 5,8 GHz. Górną granicą dla DCMI jest 5 MPix, natomiast 2-strumieniowe CSI pozwala na obsługę kamer nawet 64 MPix. Większych na razie nie widziałem.
Oprócz tego kamery mają interfejs w stylu I2C służący do konfiguracji rejestrów określających parametry pracy. Rejestrów jest bardzo dużo, w OV5642 są adresowane od 0x3800 do 0x603C. Służą do określania rozmiaru, położenia i skalowania obrazu, formatu danych wyjściowych, ustawienia czasu ekspozycji, wzmocnienia składowych kolorów, metod działania automatyki doboru jasności i barwy obrazu i wielu innych parametrów. Przebrnięcie przez ustawienie kamery to gruba sprawa. Na szczęście producenci zwykle podają przykładowe nastawy pozwalające na uzyskanie typowych warunków pracy. Pomimo to, uzyskanie stabilnej pracy wymaga dogłębnego zrozumienia zasad działania kamery. Przykładowo na pewnym etapie prac pojawił się problem z niestabilnością jasności obrazu. Okazało się, że zmieniając skalowanie (zoom cyfrowy), nie zmieniłem rozmiaru okna automatycznego pomiaru jasności obrazu, przez co pomiar działał na niemiarodajnym fragmencie obrazu. To są rzeczy do ogarnięcia, ale trzeba się liczyć, że kamera nie zacznie działać od razu. Do uruchamiania bardzo pomocna jest funkcja generowania kilku obrazów testowych. Obraz typu krata pomaga w złożeniu par bajtów w spójny obraz, a obraz typu kolorowe paski pomaga dobrać i ułożyć dane tak, aby uzyskać właściwy kolor.
Wybrany mikrokontroler posiada interfejs DCMI, więc to determinuje rodzaj kamery. Na rynku są dostępne moduły kamer z przetwornikami posiadającymi matryce o rozmiarze:
- 0,3 MPix (OV7675),
- 1 MPix (NT99141),
- 1,3 MPix (OV9655),
- 2 MPix (MT9D111, OV2640),
- 3 MPix (OV3640, OV3660),
- 5 MPix (OV5640, OV5642, MT9P111).
 Jest pokusa sięgnąć po obraz 4K i ścigać się ze światową czołówką, ale trzeba mierzyć siły na zamiary. Do przechowania tak dużego obrazu potrzeba dużo pamięci, a do jego obrobienia bardzo dużo mocy obliczeniowej. Trudno jest nawet określić, ile tego ma być, dlatego do rozpoznania tematu ograniczyłem się do kamery 5 MPix podłączonej przez DCMI. Jeżeli okaże się, że potrzeba czegoś znacznie więcej, to dopiero wtedy spróbuję sięgnąć na wyższą półkę, wiedząc już, czego dokładnie potrzebuję.
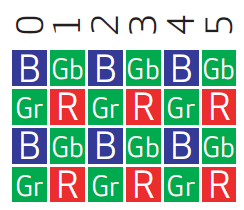
Na początku naiwnie sądziłem, że wybrana kamera 5 MPix, która ma katalogową rozdzielczość 2592×1944, da obraz tak duży, że bez przeskalowania nie zmieści się na monitorze. Jednak okazało się, że jeden piksel finalnego obrazu jest składową 4 sąsiadujących ze sobą fizycznych pikseli z nałożonym filtrem Bayera, która wygląda tak na obrazku po prawej. Połowa pikseli ma filtr zielony, ponieważ jest to kolor najbardziej czuły dla oka, pozostałe mają filtr na przemian czerwony i niebieski. Dlatego rzeczywista rozdzielczość finalnego obrazu to 1296×972 pikseli. Z tego już można wykroić obraz HD (1280×720), odpowiednio ustawiając rejestry kamery.
Na razie nie wiem, jak duży obraz będę w stanie obrabiać ze względu na wydajność procesora, więc piszę oprogramowanie tak, abym mógł podać dowolną wielkość obrazu. Ze względów praktycznych, aby rozmiar dało się zapisać na 8 bitach, ograniczyłem krok zmiany rozmiaru do 16 pikseli. Później, na etapie kompresji, okazało się, że to jest bardzo praktyczne podejście, gdyż kompresor działa na blokach 8×8 lub 16×16. Gdyby obraz miał inną rozdzielczość, niepodzielną przez 16, to jego resztę trzeba byłoby odrzucać i wprowadziłoby to niepotrzebne zamieszanie w i tak skomplikowanych algorytmach.
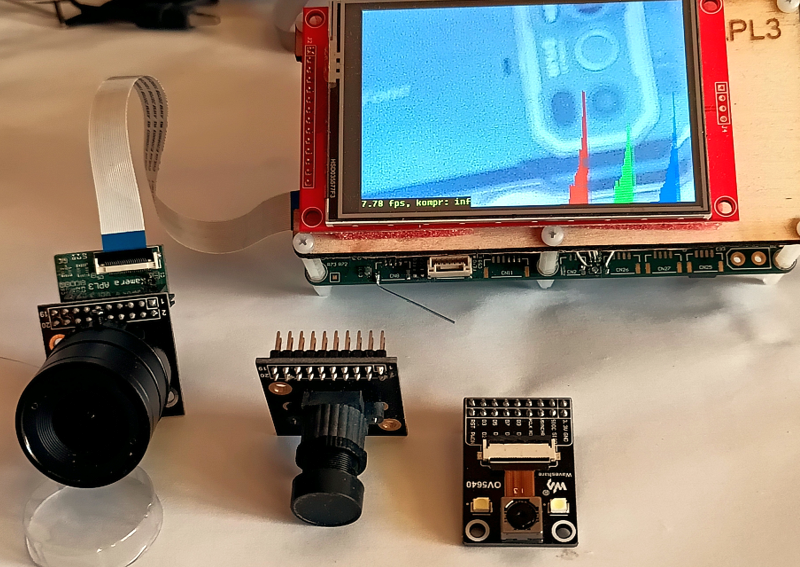
Na zdjęciu pokazany jest sprzęt z podłączonym i pracującym modułem kamery OV5642 wyposażonej w obiektyw typu C-mount. W środku taki sam moduł z obiektywem M12. Po prawej OV5640 z mikroobiektywem posiadającym funkcję autofocus. Jeżeli chcemy miniaturyzować sprzęt, to widoczna w module po prawej stronie kamera to kostka o boku 10 mm zakończona tasiemką. Taka jest realnie osiągalna dolna granica wielkości kamery w bezzałogowcu (z pominięciem większej optyki, która nie zawsze jest potrzebna).
Chyba każda kamera może oddawać obraz w jednym z kilku głównych grup formatów. Może to być grupa danych surowych, gdzie poszczególne tryby różnią się kolejnością składowych kolorów, ale to jest raczej nieużyteczne. Mogą to być dane z grupy formatów RGB, gdzie kolory mogą występować w różnej kolejności i rozdzielczości. Ta grupa formatów jest przydatna do wyświetlenia obrazu na LCD, ponieważ wyświetlacze potrzebują formatu danych, zwykle RGB565 lub RGB666. Cyfry w formacie oznaczają liczbę bitów danego koloru. Tak więc RGB565 ma 5+6+5 bitów koloru i piksel daje się zapisać na dwóch bajtach. To jest najbardziej zwarta forma obrazu kolorowego. Format RGB666 lub RGB888 zajmują 3 bajty i różnią się między sobą dynamiką koloru.
Jeżeli chcemy kompresować obraz, potrzebny będzie jeden z formatów YUV z rozdzieloną luminancją (czyli jasnością) i chrominancją (kolorem). Jednym z tych formatów jest Y8, gdzie wysyłana jest sama luminancja, czyli taki obraz jest monochromatyczny. Ponieważ zajmuje on najmniej pamięci (8 bitów na piksel) i wymaga najmniej mocy obliczeniowej do obróbki, wstępnie wybieram go do dalszych prac.
Pamięć
Obraz z kamery trzeba gdzieś przechować, zanim coś się z nim zrobi. Mikrokontroler STM32H7 w porównaniu do innych kontrolerów posiada relatywnie dużo pamięci operacyjnej, ale wciąż zbyt mało i jest ona podzielona na wiele fragmentów. Nawet jeżeli wszystkie fragmenty połączylibyśmy razem, to będzie niewystarczająco, aby móc zmieścić obraz z kamery w pełnej rozdzielczości i kolorze. Sam obraz przesłany z kamery przez DMA do pamięci to nie wszystko. Trzeba go obrobić, skompresować, przekonwertować, wyświetlić, czyli trzeba przechowywać kilka jego kopii na różnych etapach obróbki. Dodatkowo do zapewnienia płynności procesów potrzebne jest co najmniej podwójne buforowanie, gdzie jeden bufor jest napełniany, lub opróżniany, a drugi obrabiany. Tak więc nie jest łatwo oszacować rozmiar potrzebnej pamięci i lepiej, aby było jej dużo więcej, niż odrobinę mniej. Potrzebna jest pamięć zewnętrzna.
Do dyspozycji mamy pamięć statyczną i dynamiczną. Statyczną łatwo się używa, ale trudno jest wykonać ją w krzemie, przez co jest droga i ma niewielką pojemność. Dynamiczna jest bardziej wydajna w produkcji (potrzebuje mniej tranzystorów na komórkę pamięci), ale wymaga odświeżania. Nigdy nie stosowałem pamięci dynamicznych, więc w prototypie asekuracyjne użyłem obu typów: 4 MB statycznej i 64 MB dynamicznej. Jeszcze przed wykonaniem prototypu robiłem rozeznanie na zestawach uruchomieniowych, gdzie wyszło mi, że zestaw z pamięcią dynamiczną o trochę niższym zegarze, pracuje wielokrotnie wolniej, niż podobny zestaw pracujący z pamięcią statyczną. To jednak było błędne spostrzeżenie. Różnica prędkości wynikała z architektury porównywanych kontrolerów F7 i H7. Pomiary prędkości na zbudowanym prototypie pokazują, że pamięć dynamiczna działa z prędkością porównywalną do pamięci statycznej. Jednak na razie są jakieś problemy ze stabilnością danych w pamięci dynamicznej. Najprawdopodobniej nie potrafię jej poprawnie skonfigurować. To powinno dać się naprawić, ale na dzisiaj pamięć dynamiczna jeszcze nie nadaje się do używania, więc używam statycznej. Fizycznie wygląda to tak, że na obrazie są przesuwające się pasy szumu, prawdopodobnie wynikające z niewłaściwego sposobu odświeżania.
Aby magistrala danych nie była wąskim gardłem podczas obróbki obrazu, musi być szybka, czyli szeroka. Do wyboru mamy układy pamięci z interfejsem o szerokości 1, 4, 8, 16 i 32 bitów. Wewnętrzna pamięć „Axi RAM” w kontrolerze jest nawet 64-bitowa. Próbowałem uzyskać zewnętrzną magistralę 32-bitową, jednak zajmuje ona tak dużo wyprowadzeń kontrolera, że jego funkcjonalność stałaby się zbyt bardzo ograniczona. Trzeba było ograniczyć się do magistrali 16-bitowej. Tego typu projekty udowadniają, że życie jest sztuką kompromisu.
Kompresor danych
Aby obraz można było efektywnie przechowywać lub przesyłać, należy go skompresować, aby zajmował mniej miejsca. Kontroler posiada sprzętowy kompresor JPEG wyposażony w dedykowany DMA na swoim wejściu i wyjściu. JPEG jest algorytmem blokowym, pracującym na blokach obrazu o rozmiarach 8×8 pikseli. Na jego wejściu należy podać adres i rozmiar struktury przechowującej kolejkę bloków obrazu nazywanych MCU (ang. Minimum Coded Unit). Na wyjściu podaje się adres i rozmiar bufora danych skompresowanych. Kompresor obsługuje format monochromatyczny Y8, formaty kolorowe YUV444, YUV422 i YUV420 oraz format CMYK, który nas nie interesuje, ponieważ kamera nie produkuje danych w takim formacie. Większe kontrolery np. STM32MP2 obsługują jeszcze kompresję H264, która oprócz redukcji rozmiaru w przestrzeni 2D, redukuje jeszcze dane w domenie czasu, jednak w STM32H7 musimy zadowolić się samym JPEG.
Kompresja obrazu monochromatycznego jest w miarę prosta. Wystarczy obraz podzielić na bloki 8x8 i po kolei przepisać je do bufora wejściowego. Jest z tym trochę zabawy, ale należy podzielić szerokość i wysokość obrazu na 8, następnie z każdego takiego obszaru po kolei wyłuskać dane. Z powodu blokowego działania algorytmu, wskazane jest, aby rozmiary obrazu były wielokrotnością 8, gdyż resztę trzeba odrzucić albo dopełnić tym samym wzorcem, co krawędź obrazu. Jest to niepotrzebna komplikacja, więc najlepiej zadbać, aby obraz miał długość boków wyrównaną do 8 dla trybu monochromatycznego i do 16 dla trybów kolorowych.
Sprawa zaczyna się komplikować przy obrazie kolorowym. Tutaj przyjęto założenie, że dla oka jasność niesie dużo więcej informacji niż barwa. Dlatego kompresja JPEG rozdziela informację o obrazie na luminancję będącą informacją o jasności oraz na chrominancję będącą informacją o barwie. Chrominancja może być kompresowana znacznie silniej niż luminancja, bez zauważalnej utraty jakości obrazu. Dodatkowo można jeszcze bardziej zredukować liczbę chrominancji, usuwając jej część. Tak powstały tryby kolorowe:
- YUV444 jest to tryb, gdzie na każde 4 sąsiadujące piksele do kompresji wchodzą 4 bajty luminancji (Y), 4 bajty chrominancji niebieskiej (Cb) i 4 czerwonej (Cr). Czyli obecna jest informacja o barwie i jasności każdego piksela.
- YUV422, gdzie na 4 piksele luminancji przypadają tylko 2 pary bajtów chrominancji. Czyli każdy piksel ma swoją jasność, a 2 sąsiednie w wierszu mają wspólny kolor.
- YUV420, gdzie na 4 piksele luminancji przypada jedna para bajtów chrominancji. Czyli cała czwórka ma ten sam kolor, ale każdy piksel swoją jasność.
Kompresja koloru przekłada się na większy rozmiar MCU, które ma odpowiednio 3, 4 lub 6 bloków 8×8. Cały czas pamiętamy, że kompresor należy zasilać kolejnymi MCU, więc trzeba mu podać odpowiednią przeplatankę bloków luminancji i chrominancji. Taki współczesny węzeł gordyjski. Ręka córki i połowa królestwa temu, kto rozsupła go jednym przebiegiem kompilatora.
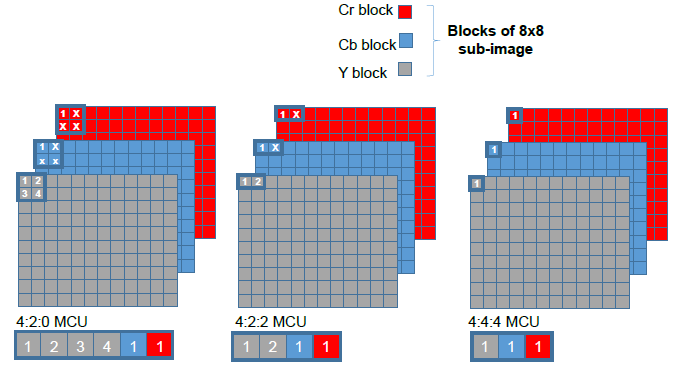
Jak można się domyślać, YUV444 generuje najlepszą jakość obrazu, ale najsłabiej się kompresuje. YUV420 ma najsłabszy obraz, ale kompresuje się najlepiej. Różne źródła podają, że do celów transmisji obrazu powszechnie wykorzystuje się YUV420. Jeszcze nie potrafię określić, jakie są różnice liczby danych skompresowanych dla różnych trybów kolorowych względem obrazu monochromatycznego, bo wyłuskanie tych danych z obrazu wcale nie jest takie proste. Raz, że trzeba operować na czwórce pikseli, co jest już niezłą gimnastyką, to jeszcze dane wychodzące z kamery nijak nie przypominają składowych kolorowych. Pomylić się można w wielu miejscach na wiele sposobów.
Kompresor może generować nagłówek obrazu zawierający informacje potrzebne do dekompresji danych. Między innymi tablice Huffmana. Zapisując obraz do pliku, trzeba oprócz nagłówka obrazu, dołożyć jeszcze nagłówek pliku o rozmiarze 20 bajtów. Ewentualnie można dołożyć blok Exif (ang. Exchangeable Image File Format), czyli informację o obrazie. Na razie dodaję Exif w formie szczątkowej, ale z biegiem czasu trzeba go będzie rozbudować o informację, o położeniu geograficznym i kątach patrzenia kamery.
Żeby móc diagnozować problemy w procesie kompresji, zrobiłem też zapis obrazu źródłowego w formacie bmp. Tutaj przed danymi obrazu powinien znaleźć się prosty nagłówek. W zależności od sposobu przechowywania występują 2 rodzaje plików bmp: z kodowaniem koloru 8-bitowym i 24-bitowym. Tam, gdzie jest 8-bitowy kolor, należy dołożyć paletę definiującą każdy z 256 kolorów. Takiego pliku używam do przechowywania danych monochromatycznych. W przypadku kodowania 24-bitowego paleta nie jest potrzebna, bo kolory same się definiują, ale taki plik zajmuje 3 razy więcej miejsca.
Poniżej jest przykładowy widok tuż po wschodzie słońca z okna siedziby PitLab mieszczącej się na samym szczycie megalitycznej budowli Wielkiej Lechii. Po lewej lub u góry jest obraz bmp, po prawej lub na dole jpeg. Oba zmniejszone dwukrotnie. Kliknięcie na obrazie pokaże oryginalny plik zarejestrowany na karcie SD urządzenia.
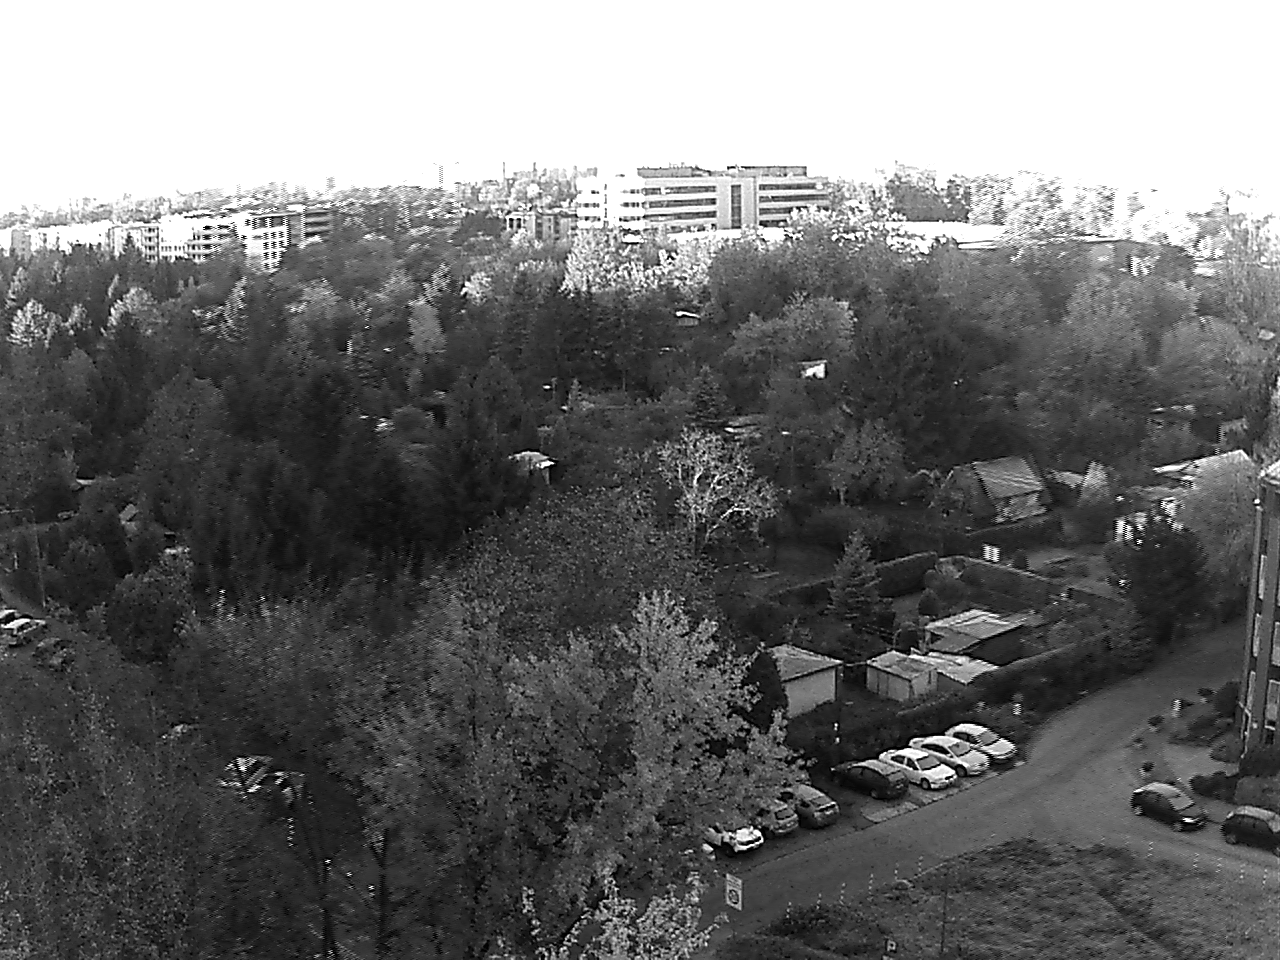
Są jeszcze pewne problemy z kompresją. Wygląda to na gubienie bloków, pomimo podwójnego buforowania na wejściu i 8-krotnego buforowania na wyjściu. Raczej nie jest to problem z buforowaniem. Może coś maże po pamięci albo jakieś przerwanie zaburza proces. To jest jeszcze do zbadania, ale już teraz pomimo ułomności procesu, widać jak to działa.
Stopień kompresji obrazu ustala się w sterowniku HAL jako liczbę z zakresu od 1 do 100. Dla jakości ustawionej na 80 uzyskuję redukcję rozmiaru obrazu monochromatycznego około 6 razy. Zmiana jakości w granicach 100-60, nie daje dużych różnic w redukcji danych. Problemy wynikające z utraty części danych co np. widać na dole obrazu jpg zaburzają pomiar na tyle, że w obecnym stanie nie ma sensu robić porównania. Zejście z jakością poniżej 50 skutkuje znacznym wzrostem kompresji, ale to dokładniej pomierzę, gdy już pozbędę się problemów wieku dziecięcego.
Gdyby tylko zależało na redukcji rozmiaru obrazu, to kamera OV5642 ma wbudowany kompresor i może wysyłać z siebie już strumień danych JPEG. Jednak chciałbym mieć możliwość pracy z obrazem, więc do kontrolera muszą dostać się w formie prostej i dopiero po obróbce mogą zostać skompresowane, stąd ta funkcjonalność kamery jest dla mnie nieużyteczna. Gdyby ktoś chciał zrobić samą transmisję cyfrową z kamery, to wystarczy taki strumień danych wysłać na ziemię.
Jeżeli chodzi o prędkość pracy sprzętowego kompresora, nie jest tak różowo, jak mi się pierwotnie wydawało. Obecnie podaję kompresorowi dane porcjami po 6 monochromatycznych MCU, czyli najprostszy możliwy format danych i ich skompresowanie, zajmuje mu średnio 136us. Chcąc uzyskać strumień danych odświeżany z częstotliwością 15 Hz, to w czasie 66 ms, jaki upływa między kolejnymi klatkami obrazu, mogę skompresować 2911 MCU (każdy 8×8 pikseli). Gdyby taki obraz był kwadratowy, to miałby bok o szerokości 431 pikseli. Czyli obrazu HD nie jestem w stanie kompresować na nawet z połową częstotliwości odświeżania. W pełnej rozdzielczości co najwyżej mogę robić zdjęcia, co około 2,7 sekundy. Ten sprzęt nie nadaje się do transmisji żywego obrazu, ale do obróbki maszynowej ma szansę wystarczyć.
DMA2D
Jest to układ DMA, specjalizowany do sprzętowego przesyłania obrazu 2D między obszarami pamięci. Potrafi w locie zrobić konwersję formatu danych. Ma też funkcję sprzętowego mieszania dwu obrazów oraz kanał Alfa, czyli przezroczystość, co powinno być użyteczne przy robieniu OSD. Pierwsze próby nakładania obrazu na obraz wyglądają jak na obrazkach poniżej. Obraz źródłowy jest rejestrowany przez kamerę w formacie RGB565 z zewnętrznie ustawionym kanałem Alfa na brak przezroczystości. Obraz nakładki jest w formacie ARGB4444. Oba obrazy wejściowe mają po 16 bitów na piksel. Obraz wyjściowy ma 24 bity na piksel, ponieważ tego wymaga wyświetlacz, oraz format pliku bmp. Obraz nakładany oprócz składowych kolorów RGB ma jeszcze kanał Alfa, czyli przezroczystość o 4-bitowej dynamice. Narysowane jest kilka pasków w podstawowych kolorach o stopniowo zmniejszającej się przezroczystości. Pod nimi są dwie linijki napisów. Pierwsza ma litery o stałej przezroczystości 50% i stopniowo zmniejszającej się przezroczystości szarego tła. Druga nie ma tła, tylko same znaki.
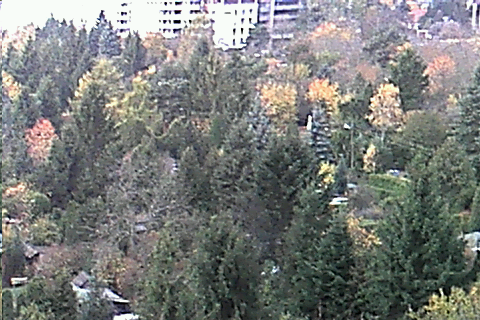
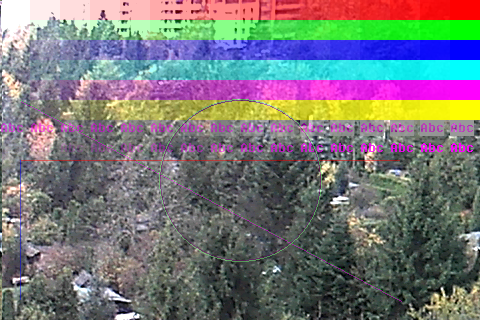
Pierwsze doświadczenia pokazują, że napisy rysowane na OSD muszą być odpowiednio kontrastowe. Przezroczystość to super sprawa i powinna być ustawiona w okolicach 50-75%, bo inaczej taki element nie będzie widoczny albo będzie skutecznie wszystko zasłaniał pod sobą. Linie rysowane o grubości 1 piksela są ledwo zauważalne. Trzeba napisać funkcję rysującą dowolną grubość. Testowo linia ukośna oraz okrąg są narysowane podwójnymi liniami o przeciwstawnych kolorach, ale to jeszcze za mało, aby były wyraźnie widoczne.
Karta SD
Obrazy, czy filmy muszą gdzieś finalnie wylądować. Typowym nośnikiem dla tego typu danych jest karta SD. Kontroler potrafi obsłużyć szybkie karty do klasy video 10 włącznie, pracujące z częstotliwością do 208 MHz po 4-bitowej magistrali. Do szybkich kart wymagany jest konwerter napięcia linii danych magistrali na 1,8 V, podczas gdy inne obwody zewnętrzne pracują na 3,3 V. Jest już to zaimplementowane w APL3 i sprzęt na razie daje radę, chociaż biblioteka HAL wymaga jeszcze trochę pracy. Problem polega na tym, że timeouty domyślnie są ustawione na wartość maksymalną i chwilowy problem, np. brak karty, praktycznie zawiesza wątek rejestratora. Ręczne poprawki znikają przy pierwszym przebudowaniu danych w Cube MX, więc tego typu naprawa nie ma sensu. Trzeba byłoby przenieść obok całą bibliotekę, ale na razie są inne priorytety. Na razie da się z tym żyć. Trzeba pamiętać, aby przed uruchomieniem urządzenia była włożona karta. Jest to problem mający potencjał do tego, aby „sam się naprawił” w kolejnej wersji biblioteki.
Ethernet
Chcąc przesłać obraz na zewnątrz, potrzebny jest odpowiednio wydajny interfejs komunikacyjny. Zdecydowałem, że będzie to Ethernet. Istnieją rozwiązania wspierające bezprzewodową transmisję takich danych np. OpenHD. Tam co prawda tam routery są podłączane przez USB, a w APL3 jest gniazdo RJ45, ale jestem przekonany, że wkrótce znajdą się jakieś ogólnodostępne rozwiązania tematu transmisji bezprzewodowej po Ethernecie. Rozwiązania komercyjne istnieją już dzisiaj, chociaż są jeszcze dosyć drogie, ale liczę na to, że z czasem będą pojawiały się tańsze.
Mikrokontroler ma wbudowany sterownik Ethernetu 100 Mbit. Potrzeba tylko dołożyć zewnętrzny układ PHY, a środowisko HAL posiada wbudowaną bibliotekę LWIP, udostępniając protokoły TCP, UDP i kilka innych. Na dzisiaj udaje się już nawiązać połączenie po TCP, chociaż obsługa programowa wymaga jeszcze dużo pracy, zwłaszcza od strony softu, który ma obsłużyć komunikację.
Docelowo chciałbym uzyskać możliwość strumieniowania obrazu, aby móc go przekazywać dalej ogólnodostępnymi narzędziami i metodami. W tym celu mam zaimplementowany serwer protokołu RTSP (ang. Real Time Streaming Protocol), który może strumieniować dane skompresowane, w tym również JPEG. Działa to w ten sposób, że ramach protokołu TCP na porcie 554 przebiega komunikacja między klientem, czyli przeglądarką np. VLC, ffmpeg, a serwerem obrazu APL3. Serwer obsługuje następujące polecenia:
 OPTIONS – serwer przedstawia listę obsługiwanych poleceń. Obecnie zaimplementowane są wymienione tutaj polecenia.
- DESCRIBE – serwer informuje, na jakim porcie wystawia dane, w jakim są formacie i co, jaki czas wysyłane są kolejne klatki obrazu.
- SETUP – odbiera od klienta nowy numer portu port i adres IP, na jaki mają być wysyłane dane.
- PLAY – klient wysyła polecenie rozpoczęcia przesyłania obrazu, a serwer tworzy nowy wątek, w którym, w ramach nowej sesji zaczyna protokołem UDP wysyłać w pętli strumień skompresowanych danych zawierających kolejne klatki filmu. W pierwszej ramce przesyłana jest tablica kwantyzacji, czyli to, co jest w nagłówku obrazu, a w kolejnych ramkach wysyłany jest już sam skompresowany obraz.
- TEAR DOWN – po tym poleceniu serwer zatrzymuje wątek wysyłający obraz.
Na razie dane połączenia są negocjowane z przeglądarką w sposób, wydaje się poprawny. Rusza streaming danych, ale w przeglądarce obraz się nie pojawia. Wydaje się, że to jest kwestia przebrnięcia przez RFC i odpowiedniej konfiguracji procesu. Może wysyłam niewłaściwe tablice albo ich format jest niezrozumiały itp.
Wyświetlacz
Jest to nietypowe peryferium jak na autopilot. Użyłem go, ponieważ pozwala na podgląd wyników pracy w prosty sposób. Zwłaszcza podgląd wyników cząstkowych, bo wyniki finalne zwykle i tak wychodzą poza urządzenie. Do samego latania wyświetlacz nie jest potrzebny, bo to tylko balast pobierający sporo energii i wrażliwy na uszkodzenia. Natomiast możliwość obejrzenia efektu bieżącej pracy znacząco przyspiesza prace rozwojowe. Wyświetlacz pracuje na magistrali SPI, co jest jego wąskim gardłem, ale magistrala może zamiast wyświetlacza obsłużyć inne urządzenia. Użycie SPI sprawia, że obraz o rozdzielczości 480×320 mogę odświeżać bez użycia DMA z maksymalną częstotliwością 7,8 Hz. Jest to dosyć mało do oglądania obrazu na żywo, ale nie chcę poświęcać cennych zasobów kontrolera do przyspieszania podzespołu nieistotnego podczas właściwej pracy. Do celów diagnostycznych ta prędkość jest zupełnie wystarczająca.
Na obecnie używanym wyświetlaczu nie mogę pokazać obrazu w pełnej rozdzielczości. Jednak dostępna moc obliczeniowa i tak nie pozwala na pracę z dużymi rozdzielczościami. Prawie na pewno większość bieżącej pracy będzie wykonywana w oknie nieprzekraczającym rozdzielczości ekranu. Jeżeli nawet będzie trzeba pracować na dużym obrazie, to do tego czasu zdążę zbudować narzędzia wyświetlające obraz na komputerze.
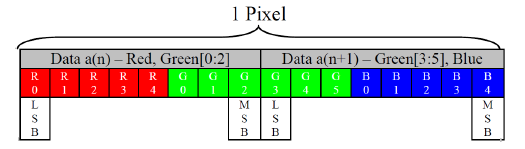
Pierwszy wyświetlacz, jakiego używałem w APL3, był dedykowany dla Raspberry Pi - LCD_TFT 3,5" (B), jednak brak dokumentacji utrudnia pracę z nim. Sposób jego inicjalizacji trzeba było zdobyć metodą inżynierii wstecznej, podsłuchując moduł. Jego naturalnym formatem przesyłania danych jest RGB565. Sposób kodowania koloru w tym formacie jest pokazany na obrazku poniżej:
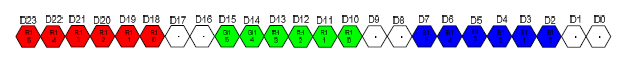
Sam wyświetlacz działa też dosyć wolno. Niedawno trzeba było zmontować jeszcze jeden egzemplarz APL3 i kupiłem dla niego nowszą, szybszą wersję LCD TFT 3,5" (C). Tutaj niestety poległem na jego inicjalizacji, gdyż brak jest szczegółowej dokumentacji a posiadanymi narzędziami nie udało się podsłuchać tak szybkiej transmisji. Finalnie kupiłem tani wyświetlacz oparty na chipsecie ILI9488, dostępny na AliExpress. Pomimo że podczas pracy z interfejsem SPI nie obsługuje on wydajnego trybu RGB565, lecz tryb RGB666, wymaga wysłania 3 bajtów na każdy piksel, tak jak pokazano na obrazku niżej. Część transmitowanych danych jest tutaj niewykorzystana. Zaletą jest brak konieczności konwersji kolorów, gdyż każdy bajt zawiera jedną składową koloru.
Mimo to wyświetlacz ma porównywalną prędkość do wersji B dedykowanej dla Raspberry Pi, przy trzykrotnie niższej cenie. Wszystkie te wyświetlacze mają ten sam sterownik panelu dotykowego.
Poprawa jakości obrazu kamery
Surowy obraz z przetwornika typu CMOS jest, delikatnie mówiąc, słabej jakości. Przez pewien czas wydawało mi się, że to kwestia regulacji parametrów, których jest kilkaset, ale podejście laika typu „pokręcę i zobaczę, czy będzie lepiej" daje dosyć niewiele. Właśnie obejrzałem film na vlogu „Kabul nadaje”, w którym omawiane są różnice między technologiami CCD i CMOS. Jest tam przedstawiona droga zamiany światła na liczbę, ze szczegółowym omówieniem specyfiki i problemów poszczególnych jej etapów.
Do tej pory dosyć intuicyjnie zdawałem sobie sprawę, że część szumów można usunąć, mnożąc macierz obrazu przez macierz korekcyjną, która uwzględnia różnice wzmocnienia tranzystorów poszczególnych pikseli. Jest to w miarę prosta operacja, ale wymagająca obróbki dużej ilości danych, przez co może mieć zastosowanie do zdjęć, ale nie do filmu. Po obejrzeniu filmu zdałem sobie sprawę, że istotnym parametrem jest również zwiększenie dynamiki. Obecnie używany przetwornik może oddawać wyniki o szerokości 10 bitów, jednak ze względu na oszczędność miejsca w pamięci stwierdziłem, że 8 bitów mi wystarczy i szkoda „marnować” pamięć i czas na dodatkowe 2 bity. Być może jednak warto po nie sięgnąć. Jeszcze jednym parametrem jest nieliniowość przetwornika CMOS. Potrzebne byłoby zrobienie pomiarów kalibracyjnych dla kilku poziomów jasności o zewnętrznie zmierzonym natężeniu światła, czyli porównaniu obrazu do znanego wzorca, aby wyznaczyć funkcję linearyzującą odpowiedź przetwornika. Łącząc te metody, być może udałoby się rozciągnąć dynamikę z 10 do 16 bitów, tak aby nie było żal poświęcać 6 bajtów na piksel zamiast 3. Teraz, gdy jest już opanowana obsługa pamięci DRAM, zniknął problem braku miejsca na obraz. Wciąż problemem jest czas na obróbkę i ograniczona prędkość pracy interfejsu, ale w najnowszych kontrolerach te problemy są już rozwiązane, więc jest sens podjąć ten wysiłek, bo przy kolejnej wymianie kontrolera pozbędziemy się i tych ograniczeń.
„”