Kompresja JPEG
Uruchomiłem już wszystkie możliwe tryby kompresji JPEG obrazu i warto byłoby je porównać. Wspominałem o nich w artykule Obraz na latającym mikrokontrolerze STM32H7. Część 1 Sprzęt. Przypomnę, że różnią się liczbą informacji o chrominancji, czyli kolorze. W trybie YUV444 każdy piksel w bloku 8×8 ma pełną informację o luminancji i chrominancji. W trybie YUV422 dwa sąsiednie bloki w rzędzie mają wspólną chrominancję pierwszego bloku. W trybie YUV420 cztery sąsiadujące bloki mają wspólną chrominancję z pierwszego bloku. W trybie Y8 jest zawarta tylko luminancja. Na typowym obrazie z kamery nie ma zauważalnych różnic między trybami kompresji kolorowego obrazu. Widać to dopiero na kontrastowych obiektach OSD, w szczególności na pionowych i poziomych liniach oraz na literach napisów. W YUV422 następuje rozmycie koloru w pionie, a w YUV420 w pionie i poziomie. Dodatkowo w trybach o zredukowanej chrominancji, jeżeli kolor występuje na obszarze mniejszym niż rozmiar bloku i trafi na blok z pominiętą chrominancją, to kolor tego obszaru nie znajdzie się na obrazie. Przy poruszającym się obrazie z kamery, jeżeli kolor punktu na chwilę zniknie, nasz mózg kompensuje tę utratę i nie przeszkadza nam to w jego interpretacji. Natomiast linie OSD , które są statyczne względem początku obrazu w sytuacjach, gdy linia znalazła się w bloku, z którego nie jest pobierana chrominancja, tracą kolor całkowicie.
Utrata jakości jest kompensowana mniejszym rozmiarem obrazu, co jest istotne, zwłaszcza przy transmisji radiowej obrazu. To jest kwestia do wyważenia, jaką utratę jesteśmy w stanie zaakceptować w zamian za redukcję rozmiaru. Jeszcze nie mam radiowego linku wizyjnego, ale już teraz można ocenić, jak parametry kompresji wpływają na percepcję skompresowanego obrazu. Dodatkowo stopień kompresji można regulować w zakresie od 1 do 100. Im większa liczba, tym lepsza jakość, ale większy rozmiar skompresowanego obrazu.Poniżej przedstawiono wykres zmiany rozmiaru pliku i stopień redukcji rozmiaru pliku dla różnych stopni kompresji
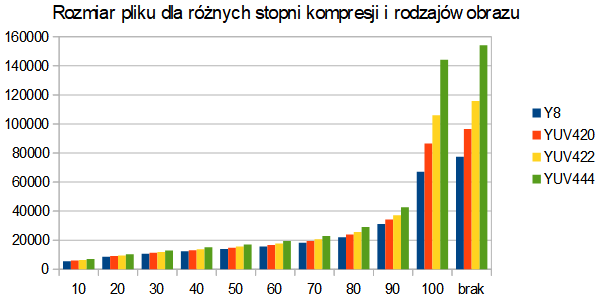
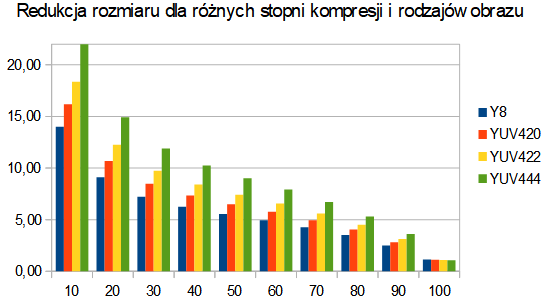
Postawą do obliczeń jest teoretyczna liczba danych wynikająca z rozmiaru obrazu i obecności składowych chrominancji powiększona o 558 bajtów bloku Exif, obecnego w każdym pliku JPG. Przyznam się, że oczekiwałem większej różnicy rozmiaru między obrazem kolorowym a monochromatycznym. Jestem pozytywnie zaskoczony tym, że algorytm kompresji pokazał swoją efektywność.
Poniżej przedstawiam tabelę z tymi obrazami w rozdzielczości 320×240. Są malutkie, na większych różnice widać lepiej, ale nie zmieszczę ich na stronie.
| Stopień kompr. | YUV444 kolor | YUV422 kolor | YUV420 kolor | Y8 monochromatyczny |
| 10 |  |
 |
 |
 |
| 20 |  |
 |
 |
 |
| 30 |  |
 |
 |
 |
| 40 |  |
 |
 |
 |
| 50 |  |
 |
 |
 |
| 60 |  |
 |
 |
 |
| 70 |  |
 |
 |
 |
| 80 |  |
 |
 |
 |
| 90 |  |
 |
 |
 |
| 100 |  |
 |
 |
 |
Kompresując obraz na PC, zwykle ustawiam stopień kompresji na 80, bo tak mi wyszło w trakcie eksperymentów, które robiłem lata temu. Silniejsza kompresja powoduje już zauważalną utratę jakości. Kompresja na mikrokontrolerze wygląda inaczej. Tutaj degradacja jakości zaczyna się znacznie niżej, ale też obraz wejściowy ma znacznie gorszą jakość niż to, do czego przyzwyczaiła nas współczesna elektronika. Jeszcze nie mam rozpoznane, dlaczego obraz ma tak słabą jakość. Być może jest to kwestia sprzętu, być może ustawień kamery. Jest to temat otwarty. Obecnie akceptowalny dla mnie poziom kompresji to 30. Poniżej litery są trudno czytelne.
Exif, czyli informacje o obrazie
Standard JPEG przewiduje mieszczenie w pliku bloku danych zawierających informację o obrazie. Dane umieszczone są w 12-bajtowych blokach nazywanych tagami zawierających pola:
- ID - 16-bitowy identyfikator rodzaju informacji.
- Typ danych (16 bitów). Nie jest zrozumiałe, dlaczego zajmuje aż tyle, ponieważ typów jest tylko kilka: BYTE, ASCII, SHORT, LONG, SLONG, RATIONAL i STRATIONAL.
- Rozmiar danych (32 bity). Również mocno przesadzona wartość, wystarczyło by 8 bitów.
- Dane (32 bity), jeżeli się zmieszczą lub offset do danych umieszczonych poza blokiem.
Pierwsze 4 typy danych są typowe dla języków programowania. Przedrostek „S” w typach SLONG i SRATIONAL oznacza liczbę ze znakiem (ang. signed). Typ RATIONAL i odpowiednik ze znakiem, służą do przechowywania liczb rzeczywistych przedstawionych jako stosunek (ang. ratio) dwóch liczb całkowitych. Jest to archaiczny sposób, w jakim kiedyś zapisywało się pseudo rzeczywiste dane w zmiennych całkowitych. Na przykład, chcąc przesłać informację o wysokości w jednostce 1 metr z rozdzielczością 10 cm, mnożyło się wartość przez 10 i przesyłało w liczbach 16-bitowych, a później do celów prezentacji dzieliło przez 10, zapisując resztę po przecinku jako dziesiątą część metra. Miało to sens na kontrolerach bez jednostki zmiennoprzecinkowej i w sytuacji, gdzie liczby rzeczywiste występują na tyle sporadycznie, że nie warto włączać dużej biblioteki do obsługi typów zmiennoprzecinkowych.
Pole rozmiar jest wyrażone w jednostkach 16 bitów, służy do określenia rozmiaru obiektu np. napisu z nazwą producenta, autora zdjęcia czy numeru seryjnego obiektywu. Tego typu zmienne nie zmieszczą się wewnątrz tagu, więc muszą być umieszczone w pamięci poza nim. Wtedy w polu danych umieszcza się offset wyrażony w słowach 16-bitowych do pierwszego słowa przechowywanej informacji. Również liczby (S)RATIONAL zajmujące 16 bajtów (2×LONG) umieszczane są poza tagiem.
Pierwsza wersja Exifa obejmowała blok tagów poprzedzony 16-bitową liczbą z jego rozmiarem i następujący po bloku obszar na dane nie mieszczące się w tagu. Później pojawiły się nowe potrzeby zapisywania kolejnych danych i z niezrozumiałego dla mnie powodu (prawdopodobnie kompatybilność wsteczna), zamiast dodać kolejne parametry do tej samej struktury, zdecydowano się, aby za blokiem danych zrobić drugą bliźniaczą strukturę składającą się z 16-bitowej liczby tagów, bloku tagów i przestrzeni na dane. Jeszcze później pojawiły się satelitarne systemy nawigacyjne i dla nich przewidziano kolejną taką strukturę. Obie te dodatkowe struktury mają swoje identyfikatory i są obecne jako tagi w głównej strukturze Exifa, a zamiast danych mają podany offset do ich początku umieszczonego za główną strukturą. Jest to mocno zagmatwane, ale po kilku dniach walki z przeciwnościami udało się to zaimplementować.
Chciałem mieć możliwość zapisywania danych, w szczególności pozycji GNSS, wysokości, prędkości i kąta elewacji kamery, gdyż na podstawie tych danych można obliczyć współrzędne obiektu, na który patrzy kamera albo poskładać obraz w ortofotomapę i tym podobne przyszłe zastosowania. Pominąłem implementację kilkudziesięciu parametrów kamery, bo one raczej są przewidziane dla profesjonalnej obróbki obrazu, a do tego jest mi daleko i nie widzę takiej potrzeby. Jeżeli w przyszłości jakiś parametr okaże się potrzebny, to go zaimplementuję. Można dodawać też niestandardowe, własne dane, trzeba tylko mieć narzędzie, które je odczyta.
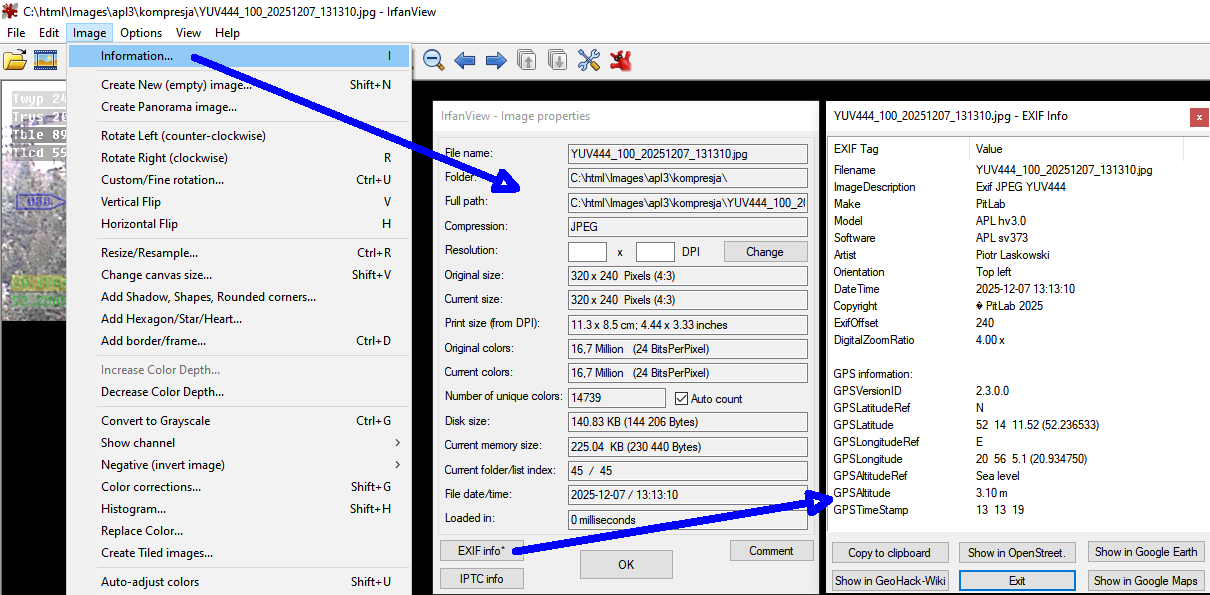
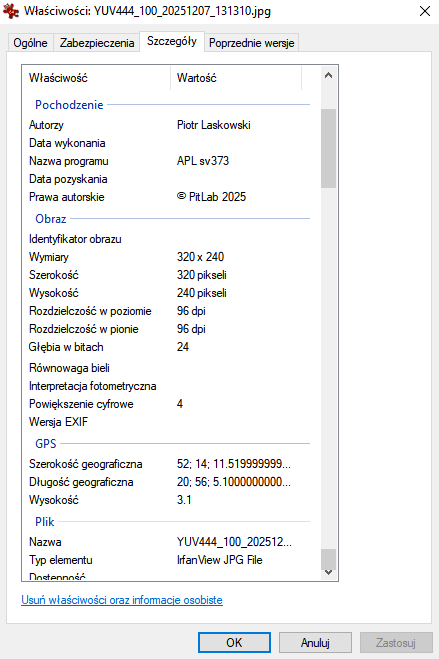
Zawartość większości pól Exifa można odczytać w popularnej przeglądarce obrazów IrfanView lub we właściwościach pliku w systemie Windows. Nie widać tam prędkości, kierunku ani kąta elewacji kamery, ale te dane są zawarte i można je odczytać bardziej rozbudowanymi narzędziami.