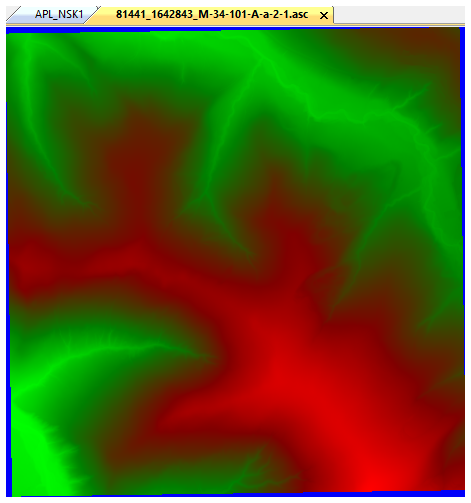
 Rozwijam filtr Kalmana wysokości. Chcę uzyskać wyznaczenie wysokości MSL i AGL niezależnie od dostępności informacji z GNSS. Doszedłem do rozmiaru wektora stanu x wynoszącego 10 elementów. Oprócz dotychczasowych: wysokości nad poziomem morza, prędkości pionowej, przyspieszenia pionowego i błędu dwóch akcelerometrów doszły: błędy pomiaru wysokości z dwóch czujników ciśnienia, błędy pomiaru wysokości dwóch odbiorników GNSS oraz wysokość terenu. Aktualizacja stanu filtra dotychczas obejmowała pomiary: wysokości MSL i prędkości pionowej z czujników ciśnienia oraz przyspieszenia pionowego z akcelerometrów. Obecnie powiększyła się o pomiary wysokości z dwóch odbiorników GNSS, pomiar wysokości lidarem i odczyt z mapy: Numeryczny Model Terenu lub Numeryczny Model Pokrycia Terenu. Nie mam jeszcze rozpoznania, która z map będzie lepsza do tego zastosowania, ale obie są zbudowane tak samo, więc to kwestia eksperymentów. Mapy są dostępne do pobrania z Geoportalu. Na obrazku po prawej znajduje się autorska wizualizacja mapy wysokościowej losowo wybranego fragmentu Tatr.
Lidar o przyzwoitym zasięgu 30–50 m w zależności od reflektancji celu już do mnie jedzie. Będzie patrzył w dół i mierzył wysokość nad poziomem terenu. Mapa to gruba sprawa wymagająca sporo pracy i przerzucania olbrzymiej, jak na dotychczasowe standardy, ilości danych. Najmniej dokładna mapa o rozdzielczości 5 m obejmująca prostokąt o rozmiarach 2200×2380 m zajmuje 1,4 MB. Mam kostkę pamięci Flash o pojemności 64 MB. Część jest zajęta na zapis konfiguracji i komunikaty głosowe, część zarezerwowana na przechowywanie elementów interfejsu użytkownika, więc zostaje 56 MB dla map i można do niej wgrać 38 kafelków mapy. Chcąc lecieć po linii prostej, byłoby to 84,6 km. Do zdecydowanej większości rozwiązań wystarczy, ale szału nie ma. Testu dalekiego zasięgu, jaki był robiony 11 września 2026, już nie da rady wykonać. Kolejna mapa NMT o rozdzielczości 1 m obejmująca podobny obszar, zajmuje już 36 MB. Tutaj dam radę wgrać do APL jeden kafelek mapy, aby pokręcić się w miejscu. Natomiast kafelek mapy NMPT o rozdzielczości 0,5 m zajmuje 142 MB.
Mapa jest w postaci tekstowej. Oprócz niewielkiego nagłówka zawiera dane w postaci „123.45 123.45”, czyli 5 znaków liczby, kropkę części ułamkowej i separującą spację. To daje 7 bajtów na pomiar. Mógłbym zapisać to jako float16, wtedy mam współczynnik kompresji wynoszący 3,5 i zmieszczę w pamięci kafelek mapy NMPT, lub 5 kafelków mapy NMT o rozdzielczości 1 m, lub 140 kafelków mapy o rozdzielczości 5 m. Do testów wystarczy, ale to pokazuje rzeczywiste zapotrzebowanie na pamięć i przepustowość interfejsów komunikacyjnych do jej aktualizacji. Przerzucenie tego UART-em trochę by trwało...
Żeby nie było zbyt łatwo, wysokość na mapie jest podana w metrach nad poziomem morza, a dane z GNSS są podane jako wysokość względem elipsoidy GRS80. Formatów danych mapy jest kilka, ale przyjmuję współcześnie obowiązujący model wysokości PL-EVRF2007-NH. Jeżeli chodzi o współrzędne geograficzne, to Numeryczne Mapy Terenu są w narodowym formacie geodezyjnym PL-2000, jako płaszczyzna mierzona w metrach od równika i bazowego południka. W Polsce mamy 4 bazowe południki: 15°, 18°, 24° i 24°. Błędy wynikające z przekształceń na styku stref wynoszą ok. 7 cm, więc na obecnym etapie są pomijalne. Mam już zrobione przeliczenie współrzędnych otrzymanych z GNSS metodą Gaussa–Krügera na współrzędne w formacie PL-2000. Nawigacja będzie odbywała się w płaskim, metrycznym systemie PL-2000, jedynie aktualizacja wysokości z GNSS będzie wymagała konwersji kilka razy na sekundę.
Tworząc nową funkcję, umieszczam w jej nagłówku podstawowe informacje w ramach dokumentacji oprogramowania. Jedną z takich informacji jest czas wykonania. Jest to szczególnie ważne dla funkcji uruchamianych w głównej pętli w ścisłym reżimie czasowym. Do tej pory praktycznie wszystkie operacje zmiennoprzecinkowe liczyłem na liczbach float, ale nie wiedząc, czego mogę się spodziewać, pierwszą wersję funkcji konwersji pozycji elipsoidalnej na geodezyjną zrobiłem na liczbach typu double. Zmierzony czas wykonania funkcji wyniósł 584 μs. To jest strasznie dużo. Podczas ostatnio robionego pomiaru pętla główna autopilota wykonywała się ok. 1800 razy na sekundę, czyli wykonanie powyższej funkcji trwa trochę więcej niż cała reszta obliczeń. Dodam tylko, że funkcja jest już wstępnie zoptymalizowana. Każde z obliczeń trygonometrycznych wykonywane jest tylko raz, a jeżeli obliczenie występuje wiele razy, to do kolejnych brany jest wstępnie przygotowany wynik. Nie mogąc znaleźć przyczyny tak długiego wykonywania, zrobiłem drugą wersję funkcji pracującą na liczbach float. Ta wersja wykonuje się 83 μs. Dopiero wtedy dotarło do mnie, że rdzeń CM4 ma koprocesor matematyczny tylko dla liczb float, a obliczenia na liczbach double robi, używając biblioteki. Dopiero rdzeń CM7 ma koprocesor do obliczeń na liczbach po podwójnej precyzji.
Jest sprawą otwartą, co z tym robić dalej. O ile odległości między południkami są niewielkie — rząd wielkości 500 km, o tyle odległość od równika jest na tyle dużą liczbą, że zapisując ją jako float w metrach, mamy rozdzielczość na poziomie jednego miejsca po przecinku. To stanowczo za mało, aby zrobić nawigację inercyjną, gdyż niewielkie sumy cząstkowe nie będą mogły zostać dodane do dużej liczby float ze względu na ograniczoną precyzję. To tak jak czerpać piasek sitem o grubych oczkach. Rozwiązaniem jest przeniesienie nawigacji do rdzenia CM7 i praca na liczbach double, ewentualnie liczenie sum pośrednich w osobnej zmiennej float i dopiero większe partie danych dodawać do globalnej pozycji. To wymaga głębszego przemyślenia i dokładnego przetestowania.
Ogólna koncepcja dwurdzeniowego autopilota opiera się na założeniu, że CM4 obsługuje czujniki, liczy IMU, PID-y, mikser, steruje mechanizmami wykonawczymi, a CM7 komunikuje się ze światem, obsługuje kamerę, robi obliczenia na obrazie, aby użyć ich jako kolejne źródło określania pozycji. Wygląda na to, że nawigacja będzie musiała być liczona na rdzeniu CM7. To nie musi być robione szybko. Spokojnie wystarczy, jeżeli wątek nawigacyjny zostanie wywołany od 10 do 100 razy na sekundę i skumuluje w sobie dane zebrane przez filtry Kalmana pracujące na CM4.
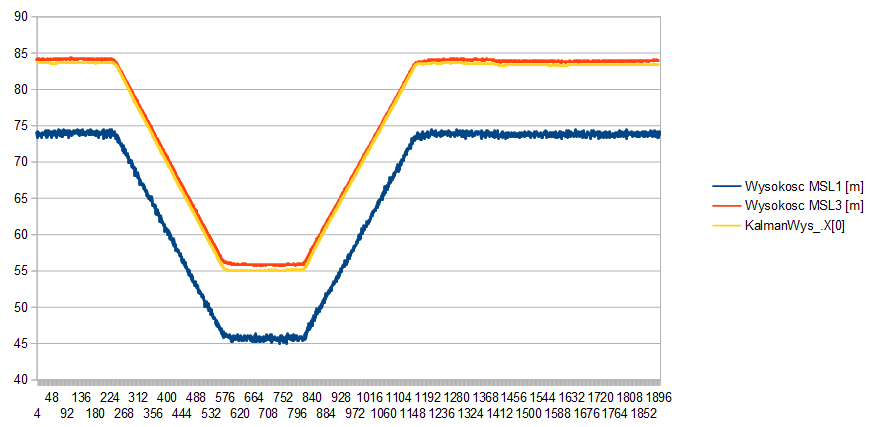
Wracam do filtra wysokości. Przetestowanie wszystkiego wymaga jeszcze wiele pracy i zajmie sporo czasu, ale już teraz można sprawdzić, jak działa estymacja błędu wysokości z czujników ciśnienia. Nie mam jeszcze pełnego domknięcia informacji o wysokości przez dane z GNSS (bo nie jest dostępny w windzie) lub tandem lidar-mapa, ale już teraz filtr wyznacza informację o błędzie. Poniżej znajduje się wykres przedstawiający wysokości z czujników ciśnienia razem z estymatą filtra. Coś, co już znamy z wcześniejszych etapów. Tutaj wyrzuciłem ręczną korekcję ciśnienia, jaką kiedyś wstawiłem do obsługi czujnika BMP585. Czujniki są bez żadnej kalibracji.
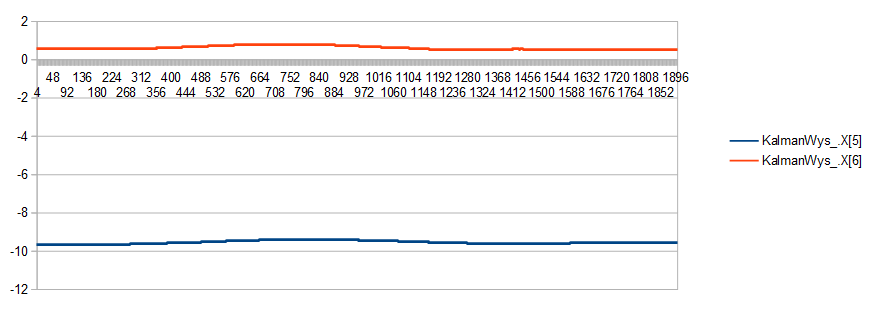
Teraz filtr wyznacza błędy wskazań czujnika względem estymaty, która statystycznie jest najbardziej pewnym elementem. Gdy dojdą czujniki bezwzględne, czyli GNSS lub lidar + mapa, to estymata będzie znacznie pewniejsza, ale zawsze to ona będzie na szczycie pomiaru. Błędy obecnie wyglądają tak jak niżej. W macierzy Q trzeba jeszcze troszkę zmniejszyć wariancję estymacji błędu, bo widać, że część informacji o wysokości wycieka do błędu. Pozycja X[5] zawiera błąd wysokości MSL, X[6] błąd wysokości MSL3.
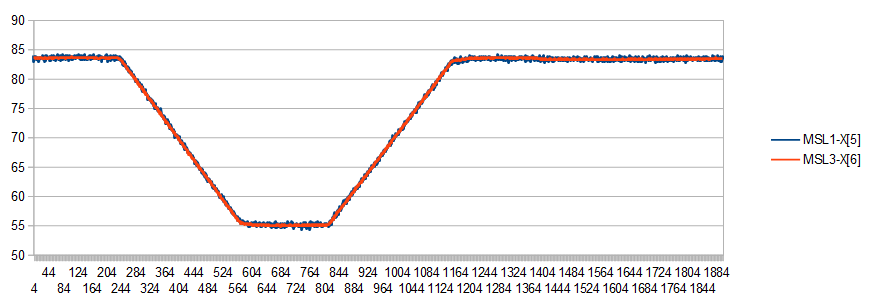
Pierwotnie chciałem od razu odjąć te błędy od wskazań czujników, ale to wprowadza zapętlenie, więc lepiej jest posiadać osobno surową wysokość i błąd. Gdy odejmę błąd od wysokości, to uzyskam taki pomiar: jak niżej. Czujniki praktycznie się pokrywają. Na tym polega piękno filtra. Jako człowiek wrażliwy wpadam w zachwyt, gdy widzę taki pomiar.