
 Rozwój autopilota przez co najmniej ostatni rok to był szybki marsz do przodu. Prawie każde podejście do projektu rano przed pracą czy wieczorem tworzyło nowy fragment funkcjonalności, aż nagle coś zaczęło się psuć i spowalniać. Po kilku dniach debugowania problemu kluczowe podsystemy praktycznie przestały działać, a kod przestał się linkować. Nie jest to aż tak wielki projekt, żeby nie dało się go ogarnąć – to efekt zaledwie dwóch lat pracy. Nie jest też specjalnie skomplikowany, kilka najtrudniejszych rzeczy jest jeszcze przede mną, a mimo to narzędzie stanęło dęba i nie jestem w stanie nawet zlinkować kodu, aby zacząć szukać przyczyny. Po kilku padach nauczyłem się, jak regenerować pliki projektu, mając plik .ioc i kod źródłowy. Trzeba skasować konfigurację, wygenerować kod z CubeMX, dodać kod z GitHuba i zwykle kolejna kompilacja i linkowanie przechodzi. Jednak po kilkudziesięciu próbach nawet to przestało działać. Jeżeli nawet udało się uruchomić kod, to blokowała się komunikacja z wyświetlaczem po SPI, prawie zawsze nie działał mechanizm wymiany informacji między rdzeniami, a prędkość pętli głównej rdzenia autopilota spadła z około 230 Hz do 13 Hz, a w najgorszym etapie walki do 6,2 Hz.
Problemy zaczęły się pojawiać w chwili, gdy przyszedł zakupiony odbiornik RC pracujący na protokole Crossfire, który trzeba było dopiero oprogramować, a w tle przygotowywałem się do uruchomienia regulatorów DShot. Zimą napisałem obsługę protokołu „na sucho”. Teraz, gdy mam już regulatory i platformę, nadszedł czas, by uruchomić to na rzeczywistym sprzęcie. Na nowej platformie, czyli Pentakopterze, zamocowałem też dwa paski programowalnych LED-ów sterowane timerem przez DMA. Pierwsze przypuszczenie było takie, że uruchomiłem zbyt dużo zasobów korzystających z DMA i być może zatyka się magistrala. W mikrokontrolerze są 3 wielokanałowe układy DMA, wszystkie kanały są zajęte, spora część z nich pracuje jednocześnie, wymieniając z pamięcią duże ilości danych. Jednak testowe wyłączenie największych producentów ruchu na magistrali niczego nie zmieniło.
Może mechanizm międzyrdzeniowej wymiany danych, które rozrosły się do 350 słów 32-bitowych, wymienianych w każdym obiegu pętli głównej, tak zapychał magistralę? Jednak to nie to, ale dane zapisywane przez rdzeń CM4 przestały być widoczne dla CM7. Dostęp do pamięci jest separowany sprzętowymi semaforami, więc nie powinno być konfliktu. Ręczne zapisanie zmiennej jakąś wartością w trybie debugowania jest widoczne podczas debugowania drugiego rdzenia, ale normalna praca, tak jak było przez ostatni rok, już nie działa. Zoptymalizowałem mechanizm przejmowania pamięci, aby żaden z rdzeni nie pisał nowych danych, jeżeli nie są odczytane stare, ani nie czytał ponownie danych już wcześniej przeczytanych. To jednak nie pomogło, a ustawiane flagi też nie były widoczne dla drugiej strony.
Kolejna sprawa to wyświetlacz współdzielący magistralę SPI z panelem dotykowym i kilkoma ekspanderami IO. Każde z nich pracuje na innej prędkości, a ekspandery obsługiwane są w innym wątku niż wyświetlacz i panel dotykowy, więc dostęp do zasobu jest chroniony kolejnym semaforem. W pewnej chwili pojawiło się coś takiego, że wysyłając 3-bajtowe polecenie do układu, fizycznie wychodziły tylko 2 bajty, a magistrala wisiała. Pojawiło się to na chwilę, potem samo ustąpiło — najgorsze, co może być. Po prostu koszmar, siła złego na jednego.
Udało mi się znaleźć kilka błędów, które były już od dawna. Na przykład spory czas temu, bez wyraźnej przyczyny, przestały działać magnetometry. Były wtedy pilniejsze rzeczy do zrobienia, więc nie drążyłem tematu. Okazało się, że przyczyną problemu są bufory na dane odczytywane z magnetometru przez SPI sterowane układem BDMA. Bufory umieszczone są w pamięci SRAM4 na magistrali AHB4, bo tylko ta pamięć ma połączenie z dosyć archaicznym BDMA. Kiedyś, szukając najlepszej nazwy dla sekcji pamięci, zmieniłem dotychczasową nazwę na nieco czytelniejszą, ale zapomniałem ją zmienić przy deklaracji zmiennej w odległym, dawno niedotykanym pliku, w którym wszystko działało. To spowodowało, że zmienna, zamiast być umieszczona w SRAM4, wylądowała w domyślnym SRAM1, a BDMA nie miało do niej dostępu. Nie potrafię jednoznacznie stwierdzić, czy to mogło powodować jakieś kolizje na magistrali, ale wydaje się, że to właśnie było istotną przyczyną spowolnienia. Oczywiście usunięcie jednego błędu prawie niczego nie naprawiło. Wyłapałem też, że podwójnie przygotowuję dane dla regulatorów DShot: raz w callbackach od połowy i całego transferu, a dodatkowo okresowo w pętli głównej, ewidentnie zaburzając proces. To jest efekt pracy dorywczej – kiedy zaczynam coś pisać, a tu trzeba wyjść do pracy i po wielu godzinach po prostu zapominam o tym, co miałem jeszcze zrobić, aby zamknąć dany temat. Znalazłem też problem polegający na tym, że port procesora używany do debugowania na oscyloskopie kiedyś przypisałem do rdzenia CM7, a obecnie próbowałem machać nim przez rdzeń CM4. To działało, ale wstrzymywało na chwilę pracę rdzenia CM7 i było pięknym źródłem opóźnień. Na pierwszy rzut oka zupełnie niewinnym i niewidocznym. Dopiero praca krokowa na podejrzanym fragmencie kodu pokazała, że machnięcie pinem uruchamia jakieś semafory systemu operacyjnego, a w tle dzieje się o wiele więcej, niż powinno.
Przełomem było rozsypanie się projektu na tyle, że nie dawało się go skompilować. Założyłem go od nowa i zdziwiłem się, konfigurując system operacyjny RTOS, że nie mogę wybrać wersji CMSIS_V1, bo jedyną dostępną jest CMSIS_V2. Zawsze pracowałem na jedynce, ale w miarę rozwoju narzędzia przeszło ono cichą ewolucję na dwójkę. Jakoś to działało do czasu, aż się rozsypało. Po dopasowaniu projektu do RTOS-a w wersji CMSIS_V2 zaczął być widoczny postęp. Co prawda wciąż nie działał wyświetlacz ani mechanizm wymiany danych, nie działała komunikacja z aplikacją na PC ani nie wymawiał on komunikatów, ale projekt się kompilował i budował. Okazało się, że bieżąca wersja Cube ma problem z generowaniem kodu obsługi przerwań. Po prostu nie wstawia funkcji obsługi w ciało funkcji przerwania, a gdy nie ma obsługi przerwań, to dany zasób nie działa. Zrobiłem to ręcznie i prawie wszystko ruszyło, oprócz wymiany danych między rdzeniami.
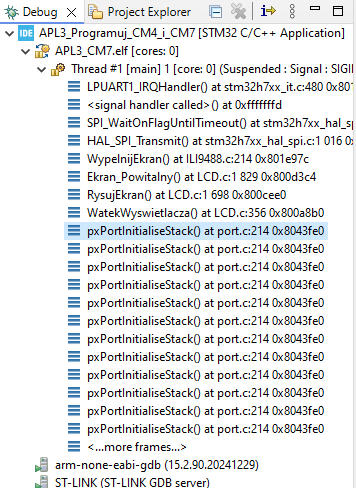 Przy okazji niedawnej aktualizacji narzędzia pojawił się dziwny problem. Już nie pamiętam pierwszego zaobserwowanego objawu, ale rozwiązaniem znalezionym w sieci była zmiana toolchaina GNU z wersji 14.3 na 13.3. Trzeba było nauczyć się zarządzania toolchainem, ale to rzeczywiście pomagało. Prawdopodobnie chodziło o współpracę ze starym RTOS-em, jednak nawet na nowym obserwuję problemy wyglądające jak błędy obsługi stosu, co widać na obrazku po prawej. Jest wiele wywołań pxPortInitializeStack(), a gdy kliknę <...more frames...> pojawia się tego więcej i więcej. Nie widać skutków ubocznych, wiec to jest być może tylko artefakt spowodowany błędem w Cube, ale na wszelki wypadek przetestowałem pracę z GNU w wersjach 13.3 oraz 12.3. Tam nie ma tego efektu. Przy okazji żonglerki toolchainem pojawił się nowy komunikat linkera: „dangerous relocation”, którego nigdy wcześniej nie widziałem. Teraz już wiem, że zabrakło wyczyszczenia projektu po zmianie narzędzia.
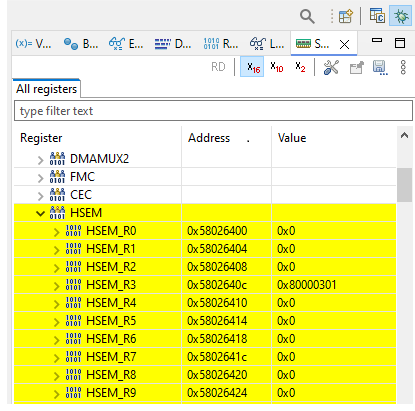
Długo walczyłem z semaforami, bo nauczyłem się, jak definiować i sprawdzać identyfikator procesu, który w danej chwili go używa. Prostą konsekwencją była obserwacja semaforów i sprawdzenie, na którym procesie zaczyna się problem. Jednak obejrzenie konfiguracji w rejestrach powoduje, że nagle wszystkie semafory, nawet te nie używane, stają się zajęte. Jak się okazało to jest fałszywy trop. Semafory tak mają, że odczyt rejestru powoduje ich zablokowanie. Finalnie okazały się niewinne. Przy okazji pracy nad nimi przebudowałem niskopoziomową część biblioteki wyświetlacza. Pierwotnie była napisana tak, że każda operacja dostępu do sprzętu była zabezpieczona semaforem. Przerysowanie ekranu wymagało, aby dla każdego piksela trzeba było pomachać semaforem. To jest szybki zasób sprzętowy, ale też zajmuje trochę czasu. Obecnie semafor chroni większą grupę operacji, co zauważalnie przyspieszyło dosyć wolne wyświetlanie.
Naprawa ostatniego poważnego błędu wymagała jeszcze 2 dni, aby znaleźć poprawkę konfiguracji Memory Protection Unit, która psuła dostęp do wspólnej pamięci obu rdzeni. MPU zarządza dostępem do wszystkich pamięci. Bufor wymiany również znajduje się w SRAM4 i zajmuje 2 kB z 64 dostępnych. Reszta podzielona jest następująco: 30 kB dla rdzenia CM4 i 32 kB dla CM7. Poprawnie ustawiłem MPU dla 2 kB bufora wymiany pod adresem 0x38000000 jako pamięć współdzieloną, bez buforowania i cache'owania, ale błędnie ustawiłem drugi obszar 32 kB (bo nie można ustawić 30 kB), zaczynający się od 0x38000800, jako umożliwiający buforowanie i cache'owanie. Błąd polegał na tym, że pozostałe 30 kB pamięci jest dedykowane rdzeniowi CM4, który nie używa MPU, a powinienem ustawić adres na 0x38008000 (jedno zero dalej), bo od tego adresu zaczyna się pamięć rdzenia CM7. Powstała zakładka 2 kB, sięgająca konfiguracją na pamięć rdzenia CM7, co powodowało, że bufor wymiany pomimo wcześniejszej poprawnej deklaracji stawał się cache'owalny i próba jego odczytania kończyła się odczytem zawartości cache zamiast pamięci. Nie jestem jeszcze na 100% pewien, ale wydaje się, że błędem było włączenie cache dla tej starej, mało wydajnej magistrali.
Kolejny znaleziony problem, który spowalniał pętlę główną autopilota to błędne użycie standardowej funkcji startu i zatrzymania timera do obsługi timera na wyjściu zanegowanym. Projektując autopilot, podczas przypisywania nóżek kontrolera do konkretnych funkcjonalności w pierwszej kolejności skupiłem się na obsłudze pamięci, bo wyjściem adresowym może być tylko jedna konkretna nóżka kontrolera. W drugiej kolejności były takie kluczowe sprawy jak obsługa kamery, karty SD, USB a wyjścia serw zostały jako przedostatnie. Brakowało mi jednego portu a był dostępny timer z wyjściem odwracającym. Obsługa tego, to kwestia ustawienia jednego bitu w konfiguracji. Zdecydowałem że ten projekt robię przy użyciu HAL, a tutaj do obsługi wyjścia zanegowanego jest osobne polecenie HAL_TIMEx_PWMN_Start_DMA() zamiast standardowego HAL_TIM_PWM_Start_DMA(). Analogicznie do zatrzymania timera jest polecenie HAL_TIMEx_PWMN_Stop_DMA() zamiast standardowego HAL_TIM_PWM_Stop_DMA(). Polecenia są podobne i wystarczyło na chwilę zapomnieć o tym że port jest zanegowany i użyć standardowej funkcji aby uzyskać efekt wolniejszej pracy całego rdzenia.
W diagnostyce bardzo pomocny był oscyloskop, a konkretnie zmiana stanu linii portu na początku i końcu pętli kopiowania danych do wspólnej pamięci. Można w ten sposób na bieżąco mierzyć czas transferu. Dla ustawienia bez współdzielenia transfer 350 słów trwa 10,2 μs. Z włączonym współdzieleniem trwa już 12 μs. Gdy naprawiłem problem z cache, ten czas ustalił się na 23,6 μs. Jest wyraźnie wolniej, ale działa. Bez oscyloskopu trudno byłoby zaobserwować efekt zmian.
Jeszcze jednym narzędziem, które potwierdziło swoją skuteczność w diagnostyce problemów związanych z wydajnością, jest okresowy pomiar czasu wykonania pewnych obliczeń. Takimi benchmarkami są obecnie pomiary czasu wykonania poszczególnych etapów pętli głównej autopilota dla rdzenia CM4 oraz czas obliczeń i rysowania na ekranie fraktala Mandelbrota dla rdzenia CM7. Te rzeczy sprawdzam już od dawna, ale teraz zacząłem je zapisywać i porównywać, bo to jest pierwsza informacja o tym, że coś zaczyna się dziać lepiej lub – przeważnie – gorzej. Żeby nie przepisywać cyferek, w debuggerze otwieram tablicę zawierającą pomiary czasu i kopiuję ją do arkusza. Dwa kliknięcia i kolumna danych jest zapisana. Resztę danych muszę przepisać ręcznie, ale z czasem może zrobię narzędzie do archiwizacji większej liczby kluczowych parametrów.
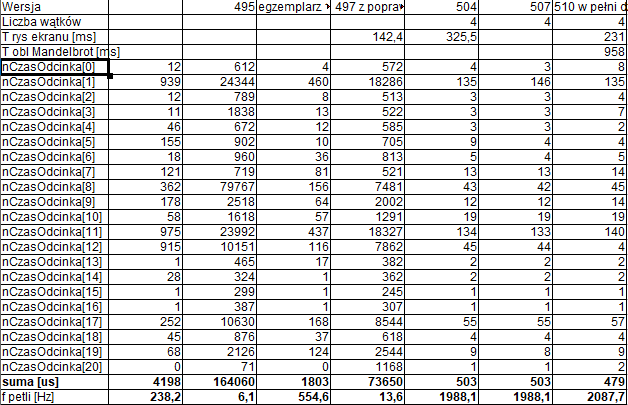
Problem odczytu magnetometrów spowodował znaczne opóźnienie wykonania pętli głównej. Najgorsze jest to, że nie jest to łatwe do znalezienia spowolnienie jednej funkcji, ale brak dostępu BDMA do bufora spowolnił wszystko. Częstotliwość działania pętli głównej w okolicach 200–300 Hz nie była czymś tragicznym i szybko się do tego przyzwyczaiłem, bo nie miałem punktu odniesienia. Teraz po naprawie częstotliwość obsługi pętli przekroczyła 2 kHz i to już jest rakieta, o jakiej nawet nie marzyłem.
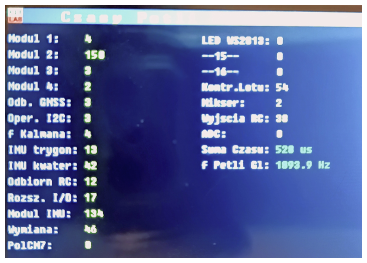 Żeby mieć narzędzie zawsze pod ręką powstała też wersja wbudowana. Na obrazku obok pokazana jest sytuacja z uruchomionymi dwoma kanałami DShot, oraz działającą taśmą czterdziestu programowalnych LED, tworzącą dwa programowo rozdzielone wskaźniki. Obieg pętli spadł z 2,1 do 1,9 kHz ale to wygląda naturalnie, bo to są ciężkie protokoły wymagające przerzucenia dużych ilości danych i częstej aktualizacji bufora. Mając takie narzędzie mogę obserwować każdą zmianę, czy nie ma gdzieś ukrytego problemu.
Do rozwiązania został jeszcze problem obliczeń fraktala. Sam fraktal jest nieistotny, ale to, że generuje się stanowczo za wolno, świadczy o jakimś problemie. Na samym początku, gdy robiłem wstępne rozeznanie możliwości obróbki obrazu, zrobiłem pomiar czasu dla fraktala o rozdzielczości 320×240 pikseli. Wtedy wychodziło mi 141 ms dla procesora taktowanego 400 MHz, prostej pętli bez OS i bufora umieszczonego w pamięci AXI. Obecnie dwukrotnie większy obraz 480×320 umieszczony w DRAM i uruchamiany pod kontrolą systemu operacyjnego razem z innymi 4 wątkami na procesorze pracującym na 480 MHz zajmuje aż 958 ms. Różnica jest olbrzymia, a oczekiwałbym, że powinna być około dwukrotna. Jeszcze nie wiem dlaczego, ale miejmy nadzieję, że korzystając z tego narzędzia, będę w stanie zmierzyć, co i w jakim stopniu wpływa na wydajność tego rdzenia. Niewykluczone, że tutaj też mam jakiś niezdiagnozowany problem.
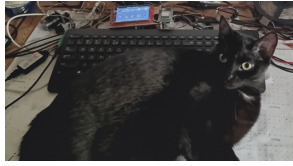 Ostatnim zdiagnozowanym źródłem błędów w projekcie są wstrzyknięcia obcego kodu wprowadzone przez dwie agentki z Krainy Ciemności: Mruczysławę i Kokosię. O ile wprawny programista pisze 10 palcami, o tyle one potrafią pisać czterema łapami, a nawet bokiem, w szczególności gdy dyskretnie położą się tuż przy klawiaturze. Na szczęście kompilator dosyć dobrze radzi sobie z wykrywaniem takich wstawek. Jednak wróg nie śpi i nigdy nie wiadomo, czy dywersantki nie przejdą zaawansowanego szkolenia i zaczną pisać trudniejszych do wykrycia wirusów.
Przez te 2 tygodnie poświęcone na szukanie błędów, można było rwać włosy z głowy i soczyście przeklinać, ale to niewiele by dało. Po raz kolejny doświadczam tego, że trudny błąd w projekcie jest błogosławieństwem, a nie przekleństwem. Zawsze jest spora szansa, że podobna sytuacja zdarzy się jeszcze nieraz, ale czas poświęcony na rozwiązanie problemu zaowocował tym, że kolejnym razem to będzie „bułka z masłem”. Jeszcze zimą planowałem, że na Wielkanoc, czyli na drugie urodziny projektu, wzniosę się w powietrze. Nie udało się i jeszcze nie jestem nawet blisko. Na szczęście mam ten komfort pracy, że nie gonią mnie terminy i mogę sobie pozwolić na spokojne dopracowanie kodu.